内容
研究背景:文学研究 × データサイエンス
12.1.1 ディスタント・リーディングの理論的枠組み
文学研究における「distant reading(ディスタント・リーディング)」は、2000年に Franco Moretti によって提唱されて以来、その概念と方法論の両面で多くの変遷を経てきました。Moretti は従来の精読(close reading)偏重の文学研究に異議を唱え、極端に少数の作品だけを尊重する精読を「神学的」とまで評しました。そして彼は「テキストの読み方は既に知っているのだから、今度はテキストを読まない方法を学ぼう」と挑発的に呼びかけたのです。
Moretti がこのように精読を批判した背景には、従来の文学研究がごく限られた正典(カノン)の作品群に依拠しすぎているという問題意識がありました。実際、彼によれば研究対象となる西洋文学作品は出版されたもの全体の「1%にも満たない」範囲に偏っています。Moretti はこのような「未読の巨大な作品群(the great unread)」を視野に入れるには、個々の作品を読む伝統的方法では不可能だと考えました。
こうした問題意識から、Moretti は世界文学を統計的・地理的・社会的に捉える実験的な研究を次々と展開しました。その代表例が『Graphs, Maps, Trees』(2005年)であり、文学テキストの大規模なパターンを可視化するためにグラフ(統計図表)、地図、樹形図といった手法を駆使しています。これらのアプローチは、個々のテキストに密着した精読では見いだせない大きな歴史的傾向や構造を浮かび上がらせ、ディスタント・リーディングの可能性を示すものとなりました。
12.1.2 文学理論の流れに位置づける ── 遠読は「表層的読解」の延長
第11回(11.3 C)では、文学理論が磨いてきた4つの読解──対位法的・徴候的・表層的・修復的──を学びました。遠読(ディスタント・リーディング)は、この流れの中にはっきりと位置づけられます。単なる新しい技術ではなく、「テキストをどう読むか」という文学理論の長い論争のなかから生まれた一つの立場なのです。
まず、その4つの読解を簡単に押さえておきましょう。いずれも「テキストの何に・どう注意を向けるか」という姿勢の違いです。
① 対位法的読解(contrapuntal reading)
エドワード・サイード『文化と帝国主義』に由来。ある作品を、それが沈黙させている声や排除された歴史(たとえば被植民者の視点)と「重ねて」読む方法。支配的な語りの裏で響くもう一つの声を同時に聞こうとする姿勢で、音楽の対位法(複数の旋律を重ねる)が名の由来です。
② 徴候的読解(symptomatic reading)
アルチュセールやジェイムソンに連なる「深層の読み」。テキストの表面ではなく、その空白・矛盾・抑圧されたものを「徴候」として読み取り、背後に隠れた意味やイデオロギーを掘り当てようとします。リクールの言う「疑いの解釈学」の典型で、20世紀後半の批評を長く主導しました。
③ 表層的読解(surface reading)
ベスト&マーカス(2009)の提唱。深層を掘らず、テキストの表面に明らかに在るもの──形・パターン・語の分布・構造──をそのまま記述する読み。「隠れた意味」より「見えているものを正確に捉える」ことを重んじます。遠読はこの表層的読解の大規模・量的な一形態です。
④ 修復的読解(reparative reading)
イヴ・セジウィックの議論。暴露と疑いを旨とする「偏執的読解(paranoid reading)」への批判として示された姿勢で、傷つきや断片から希望・喜び・つながりを組み立て直す、情動的で回復的な読み。テキストを「敵」として暴くのではなく、そこから何を得て生きられるかを問います。
20世紀の文学研究を長く支配したのは、精読(close reading)と、テキストの背後に隠れた意味やイデオロギーを掘り当てる徴候的読解(深層の読み=「疑いの解釈学」)でした。2000年代、その「深読みのしすぎ」への反動として、テキストの表面に明らかに在るもの(形・パターン・分布)に注意を向ける表層的読解(surface reading, Best & Marcus 2009)が提唱されます。
ここが要点です。ベスト&マーカスは、モレッティの遠読を「表層的読解の一形態」として明確に位置づけました。膨大なテキストを俯瞰し、語・ジャンル・主題の分布やパターンを記述する遠読は、深層を掘らずに表面を量的に読む営みだからです。同じ「疑いの読み」からの転回は、セジウィックの修復的読解(偏執的読解への批判)にも見られ、遠読・表層的読解・修復的読解は、徴候的読解の支配に対するポスト批評(post-critique)的な転回としてゆるやかに連なっています。
さらに遠読は、対位法的読解(複数の声を重ねる)とも響き合います。少数の正典(カノン)だけでなく「未読の巨大な作品群(the great unread)」を地図に載せ、これまで聞かれてこなかった作品群に光を当てようとするからです。
これまでの主流:深層・疑いの読み
精読(close reading)+徴候的読解。少数の正典を、背後に隠れた意味へ向けて深く読む。
転回:表層・記述の読み → 遠読
表層的読解(Best & Marcus 2009)が表面のパターンを記述。その量的・大規模版が遠読(Moretti)。
深層から表層へ、少数から多数へ──これが、文学理論の中で遠読が占める位置です。次節以降の技術(収集・前処理・分析)は、この「表層を大規模に読む」という読解戦略を実際に動かすための道具立てだと考えてください。
12.1.3 ディスタント・リーディングと自然言語処理(NLP)との接続
ディスタント・リーディングを支える方法論は、大量のテキストを対象とする分析技術に基づいています。Moretti はこの操作化こそが計算批評(computational criticism)の核心であると述べており、「概念から測定へ、そして現実世界へ橋を架ること」を意味すると説明しています。
具体的な分析手法としては、テキスト中の単語やフレーズの出現頻度を数える基本的な統計から始まり、スタイロメトリー(文体計量)、トピックモデル分析(Topic Modeling)、感情分析(sentiment analysis)、固有表現抽出(NER)による人物・地名の網羅的抽出、機械学習によるテキスト分類など、多様な NLP 技法が応用されています。
近年では Transformer を基盤とした言語モデル(BERT や GPT-4、GPT-5 など)が登場し、テキストの意味や文脈をより精細に捉えた分析が可能になりました。ただし、モデルが高度化する一方で、その結果に対する解釈や評価はなお人文学者の判断に委ねられる部分が大きく、アルゴリズムが示すパターンを人間の文脈知と照合する作業は欠かせません。
12.1.4 ディスタント・リーディングを巡る批判と議論の動向
ディスタント・リーディングの台頭は、従来の文学研究者から様々な反響を呼び起こしました。当初、Moretti の挑発的な主張は論争の的となり、精読を重視する批評家からは反発も招きました。「読まない読み」は文学解釈の本質を損なうのではないかとの懸念も表明されました。しかし一方で、その大胆な視点は文学研究に新たな可能性を感じさせ、多くの議論を刺激する契機ともなりました。
批判的立場
Drucker (2017):コンピュータによるテキスト処理は「字義通りで自動的・反復的」な行為であり、人間の読む行為(観念的で解釈的・生産的な行為)とは本質的に異なると指摘。Nan Z. Da (2019):計量的な文学研究(CLS)を徹底的に検証し、統計的手法の使い方に問題があると指摘。「質の低い文学批評」を生み出しがちであると断じました。
支持的立場
Underwood (2019):大規模分析の成果が文学研究に新たな知見をもたらすことを強調し、この種の定量研究は十分に価値があると述べました。Jockers (2013):個別テキストの精査(ミクロな読解)に対し、何百ものテキストを数量的に俯瞰する「マクロ分析」を導入することで、文学全体像の理解が深まると論じています。
現在では、ディスタント・リーディングは伝統的な精読と対立するものではなく、補完し合う関係にあるという見方が広がっています。遠隔読解で得られたマクロな視点の発見は、再びミクロな精読にフィードバックされるべきです。ディスタント・リーディングと精読の併用、いわば「中間距離の読解」へと向かう動きもあり、二者を統合したスケーラブルな読解戦略が模索されています。
テキストデータの収集
ディスタント・リーディングを実践する第一歩は、分析対象となるテキストデータの大規模な収集です。従来の文学研究では数作品の精読で十分でしたが、ディスタント・リーディングでは何百・何千もの作品テキストを揃える必要があります。
電子テキストアーカイブの活用
具体的なテキストデータの入手源としては、インターネット上の電子テキストアーカイブが重要な役割を果たします。代表的な例として Project Gutenberg は数万点に及ぶパブリックドメインの文学作品をテキストファイルで提供しており、19世紀英文学の主要な小説(ジェーン・オースティンやチャールズ・ディケンズ、アーサー・コナン・ドイルなど)の全文データを容易に取得できます。他にも、Internet Archive や Google Books、HathiTrust のデジタルライブラリには19世紀の書籍が大量にスキャン・電子化されています。ただし、こうした大規模データを直接扱うにはプログラミング知識や専門的なデータ取得手法(例えば API の利用やウェブスクレイピング)が必要になる場合もあります。
コーパス構築の戦略と注意点
コーパスを構築する際には、まず対象とする時代やジャンル、作品の種類を明確に定めます。例えば「19世紀イギリスの小説」を対象にする場合でも、範囲を 1800–1899 年とするのか、ヴィクトリア朝(1837–1901年)に限定するのか、あるいは英国以外で英語で書かれた小説も含めるのかなど、スコープの設定次第で集める作品が変わります。
データ収集にあたって忘れてはならないのが、収集対象のバイアスと網羅性の問題です。簡単に手に入る電子テキストは有名作家や正典(カノン)に偏りがちであり、Moretti 自身が批判した「精読が神学的だ」(ごく一部の作品に偏重している)を、ディスタント・リーディングでも繰り返してしまう危険があります。
テキストの品質とメタデータ
もう一つ考慮すべきポイントは、テキストデータ自体の品質と、その周辺情報(メタデータ)です。特に過去の作品を扱う場合、電子化のプロセスで生じるノイズや欠損に注意しなければなりません。19世紀の書籍はしばしばスキャン画像から OCR でテキスト化されていますが、その認識精度は必ずしも高くありません。
さらに、集めたテキストに付随するメタデータ(書誌情報)もできるだけ確保しておきたいところです。作品名、著者、出版年、ジャンル、初出版媒体(雑誌か単行本か)といった情報は、分析結果を解釈する上で極めて有用です。また、データ収集のグローバルな偏りにも留意すべきです。英語圏の19世紀文学などは大規模に電子化されていますが、非英語圏や周縁地域の文学作品は未だデジタル化が進んでいないケースも多くあります。
現代作品・翻訳テキストの収集 ── スキャン+OCRという選択肢(→ 12.5 の事例)
パブリックドメインでない現代の作品や、その翻訳は Project Gutenberg のような無料アーカイブには載っていません。本回の事例(12.5)が扱う村上春樹の英訳のように、対象が著作権保護下にある場合は、印刷本をスキャンして OCR でテキスト化するという収集経路が現実的になります(研究目的での扱いには権利処理や利用条件への配慮が必要です)。
この経路では、12.3 で扱うOCRノイズの洗浄が分析の成否を左右します。また翻訳研究では、作品名・原著者に加えて「翻訳者」「翻訳の刊行年」といったメタデータが決定的に重要です。同じ原作者でも翻訳者が異なれば文体が変わるため、翻訳者情報があってはじめて「翻訳の特徴」を比較できます。
テキストデータの前処理
大量のテキストデータを収集した後は、それらを分析に適した形に整える「前処理(プリプロセッシング)」の工程が待っています。生のテキストデータは往々にしてそのままでは計算機による分析に適しません。不要なノイズを含んでいたり、形式が統一されていなかったり、人間にとっては意味があっても機械的処理には向かない構造を持っていたりするためです。前処理とは一言で言えば、テキストから分析に不要な要素を取り除き、扱いやすいデータ形式に変換するプロセスです。
不要部分の除去(クリーニング)
電子化された小説テキストには序文や注釈、校訂者による解説、さらには Project Gutenberg の場合は冒頭や末尾にライセンス情報やスキャン提供者メモが含まれていることがあります。文学研究の分析ではこれらは普通不要ですから、自動的に検出して削除するスクリプトを書くか、規則に従ってトリミングする必要があります。OCR で生成されたテキストの場合、改行や段組みの痕跡が不自然な位置で挿入されていることがあるため、一旦すべての改行をスペースに置換してから段落単位で再構築するといった処理も有効です。
文字・表記の統一(正規化)
19世紀のテキストでは表記ゆれが現代以上に多様です。綴り字が時代や作家によって異なる場合や、大文字小文字の使い方、句読点の打ち方なども揺れがあります。分析目的によってはこれらを正規化(ノーマライズ)することが望ましいでしょう。例えば単語頻度を数える場合、大文字と小文字の違いは区別しない方が語数計測の精度が上がります。そのためテキストをすべて小文字化(lowercasing)する処理は基本的によく行われます。
トークナイズ(単語への分割)
英語テキストの前処理では、単語への分割(トークン化)も不可欠なステップです。人間は文章を読んで自然に単語を認識できますが、計算機は空白や句読点を手がかりにして単語境界を判断します。前処理段階では、テキストを適切に処理して単語単位のリスト(トークン列)を取得します。多くの場合、句読点は除去し、記号も分析には使わないので削除します。また数字も普通はテキストの内容分析からは外すため 0-9 の数字をすべて 0 に置換するか削除することが多いです。
ストップワード除去・ステミング/レンマ化
頻度分析やトピックモデルなどでは、あまりにも出現頻度の高い単語は分析上のノイズになることがあります。英語では "the", "of", "and" などの超頻出語(いわゆるストップワード)は文書間の差異を生みにくいため、場合によっては除去します。ただしスタイロメトリーの文脈では、逆にそれら超頻出の機能語こそが文体の特徴を担うと考えられており、分析目的によって判断が必要です。
ステミングは語尾変化を切り落として語幹(stem)を抽出する簡易的な方法で、例えば "walking","walks","walked" をすべて "walk" に変換するといったルールに基づきます。一方レンマ化は辞書的な原形(lemma)への変換で、動詞なら原形、名詞なら単数形に統一する処理です。
データ形式への変換
テキスト前処理の最終段階として、分析手法が直接扱えるデータ形式への変換があります。多くの計量テキスト分析では、文書ごとの単語頻度表(ドキュメント-ターム行列)や、単語の出現リストを使います。テキストコーパスを構築・前処理する過程には編集者(研究者)の判断や介入が多分に含まれます。そのため、どう前処理したか(例えばどの単語を除去したか、どう正規化したか)を記録し公開することが、研究の再現性のためにも望ましいとされています。
具体例:作品ごとに異なるOCRノイズを洗う(→ 12.5.1)
前処理の難しさは、本回の事例(12.5)でも実感できます。村上春樹英訳のスキャン由来コーパスには、行末の空白が文字に化けて単語が連結する3種類のノイズ ── 中置 s(Isbumped=I bumped)・先頭 s(sthe=the)・空白脱落(ofthe=of the)── が作品ごとに違う形で混在していました。単純に文字を消すと正しい語まで壊れるため、辞書と頻度を使って語の境界を復元しつつ固有名詞(Tengo, Aomame)を保護する処理を実装し、辞書語率を 87%→97% などへ改善しています。前処理の質が後段の分析すべてを左右する好例です。
テキストデータの分析
十分な規模のテキストデータを収集し、それをクリーンな形に前処理できたら、いよいよディスタント・リーディングの核心である「分析」の段階に入ります。いずれの手法も大量のテキストから人間の読みでは見つけられないようなパターンを抽出し、それを文学的知見へと結びつけることを目指す点で共通しています。
頻度分析と語彙統計
分析の入口として、まずは基本的な記述統計にあたる単語頻度や語彙の多様性を見ることが考えられます。例えばコーパス全体で最も頻出する単語は何か、各作品ごとに特徴的な単語はあるか、語彙の豊富さ(タイプ数/トークン数の比率や平均文長など)はどうか、といった指標は、大まかに文体や内容の傾向を掴む手がかりになります。頻出語の分布という基本的な統計からジャンル間・時代間の違いを捉え、研究の仮説づくりに役立てることができます。なかでも TF-IDF(ある語が特定の作品・集団でどれだけ「特徴的」か、ありふれた語を割り引いて評価する指標)は、各作品や各書き手「らしい」語を浮かび上がらせるのに有効で、結果はワードクラウドとして可視化できます(→ 12.5 ①)。
スタイロメトリー(文体計量)
Burrows 以来の伝統的な方法は、超頻出語の出現比率を各テキストについて算出し、それらを多変量解析にかけて文体の類似・相違を明らかにするというものです。具体的には、例えば19世紀の主要な小説家(オースティン、ディケンズ、トーマス・ハーディ等)の作品をすべてコーパスに入れ、各作品における上位 n 語の割合を計算します。次に、それら割合のプロフィールに基づいて作品間の距離を測り、主成分分析(PCA)やクラスター分析で可視化します。すると、驚くべきことに作家ごとに作品がまとまってクラスターを形成したり、年代順に変化する軌跡が見えたりします。同じ発想は「翻訳者の文体差」の検出にも応用できます。本回の事例(12.5)では、同一原作者(村上春樹)の作品でも、機能語の使い方から翻訳者ごとの「指紋」が浮かび上がることを示します。Burrows's Delta によるクラスタリングや、文長・句読点・節の複雑さといった指標が、翻訳者の文体を特徴づけます。
単語・文の埋め込み × 次元削減(意味の地図)
近年のディスタント・リーディングで急速に普及したのが、埋め込み(embedding)を使う手法です。BERT などの言語モデルは、各単語・文・パッセージの「意味」を数百次元のベクトルに変換します。これを UMAP や t-SNE で2次元に圧縮すると、意味の近いテキストが近くに、遠いものが離れて配置され、コーパス全体の「意味の地図」を描けます。頻度ベースの手法が表層の語の一致を見るのに対し、埋め込みは言い換えや文脈を捉えられるのが強みです。本回の事例では、約8,900のパッセージを文埋め込み+UMAPで地図化し、作風の差が空間構造として現れる様子を可視化します(→ 12.5 ②)。
トピックモデル分析(LDA/BERTopic 等)
Blei らによって提唱された潜在的ディリクレ配分(LDA)に代表されるトピックモデル手法では、コーパス内の単語の共起パターンから、文書集合に潜む「トピック」を自動推定します。例えば19世紀小説 3000 冊に LDA を適用すると、「産業革命の経済活動に関するトピック」「恋愛や結婚に関するトピック」「植民地や異国が舞台の冒険に関するトピック」など、コーパス内で頻繁に一緒に現れる単語の集合が抽出されるでしょう。ただし Lisa Rhody はトピックモデルの結果だけを眺めても既存のカテゴリーをなぞるような平板な解釈に陥りがちだと批判しており、モデルが吐き出すトピック語群にどのような意味づけを行うかが研究者の腕の見せ所となります。近年は、単語の共起だけに頼る LDA に代わり、文の意味ベクトル(埋め込み)を使うトピックモデル(BERTopic など)も広く使われます。これは前項の「単語・文の埋め込み」と地続きの手法で、文脈を踏まえたまとまりの良いトピックを得やすいという利点があります(→ 12.5 ③)。
感情分析(センチメント分析)
テキストマイニングの代表的手法で、文学作品のトーンやキャラクターの心情推定に応用されています。例えば長編小説の各章ごとに感情語をスコアリングし、物語全体の感情曲線(プロットアーク)を描くことができます。19世紀のゴシック小説であれば、クライマックスに向けてネガティブな語が増え恐怖の度合いが高まるといったパターンがあるかもしれません。ただし、古い文学作品では感情表現が婉曲的だったり、ポジティブな語とネガティブな語が反転した意味(皮肉や風刺)で使われたりする場合があるため、単純な極性分析が妥当しないこともあります。
ネットワーク分析による物語構造の解明
さらに進んだ分析として、抽出した対話情報から小説内の登場人物同士の関係ネットワークを構築した研究もあります。Elson らの研究は、60作品もの19世紀小説を自動解析して得られたネットワーク指標を比較することで、従来は数作品の例示で語られていた文学理論を大規模に検証しています。Moretti も『ネットワーク理論、プロット分析』(2011年)でシェイクスピアの戯曲に登場人物ネットワークを適用しています。このようにネットワーク分析は、小説世界の構造(誰と誰がどの程度関わるか)を客観指標で表し、それを作品間で比較することで新たな視点を提供してくれます。
機械学習によるテキスト分類
ディスタント・リーディングの分析では、機械学習を用いたテキスト分類も強力な手法です。Underwood の近年の研究では、数千冊規模の文書集合に対し「これは小説か否か」を判別する分類モデルを学習させ、フィクションとノンフィクションの言語的差異を定量的に測定しています。その結果、小説とノンフィクションは時代が下るにつれて語彙選択の面で乖離が大きくなり、1900年頃までにかなり明確に区別できるようになることが示されています。分類を文学的「証拠」として使うには、評価の厳密さが欠かせません。たとえば本回の事例では、テスト作品を学習から完全に除外する交差検証(Leave-One-Out)で「内容を見ずに文体だけで翻訳者を当てられるか」を測り、さらに並べ替え検定で「偶然そう見えるだけ」でないことを統計的に確かめています(→ 12.5)。
分析結果の解釈と精読との接続
大規模テキスト分析から知見を引き出す際には、常に批判的なまなざしと人文学的な仮説が必要です。近年は単なるデータマイニングではなく仮説検証型の遠隔読解が推奨されています。つまり「データに何か面白いパターンはないか」と闇雲に探すのではなく、「この歴史的現象はテキスト上にどのように現れているか」という問いを立て、それに答えるための指標を計量分析で求めるという姿勢です。ディスタント・リーディングは決して精読(close reading)と対立するものではなく、むしろ補完的な関係にあります。
事例研究:村上春樹 長編小説 英訳コーパスの遠読
ここまで学んだ「収集(12.2)→ 前処理(12.3)→ 分析(12.4)」の流れを、実際のコーパスで一気通貫に動かしてみましょう。題材は村上春樹の長編小説14作品の英訳(1979–2017年、英訳本をスキャン → OCR したテキスト、合計約184万語)です。村上作品の英訳は Alfred Birnbaum・Jay Rubin・Philip Gabriel・Ted Goossen という複数の翻訳者が手がけており、本事例の中心的な問いは「翻訳者ごとの文体差(=翻訳の特徴)を、データから捉えられるか」です。分析は Python(scikit-learn / sentence-transformers / UMAP / BERTopic / NLTK / networkx)で実装しました。以下では得られた図を一つずつ、「どう読めばよいか(図の読み方)」も添えて見ていきます(対話的に操作できる可視化はページ末尾のリンクから開けます)。
12.5.1 コーパスと前処理 ── OCRノイズとの格闘
12.3 で学んだとおり、OCRテキストの洗浄はすべての土台です。本コーパスには行末(原書の改行位置)に由来する3種類のノイズが作品ごとに混在していました ── ①中置 s 置換(Isbumped = I bumped)、②先頭 s 付与(sthe = the)、③空白脱落(ofthe = of the)。単純に文字 s を消すと正しい単語まで壊れるため、辞書(NLTK words + 活用形)とコーパス自己頻度を併用した語境界復元アルゴリズムを実装し、固有名詞(Tengo, Aomame など)を保護しながら復元しました。
結果、「辞書語率」(英単語として認識される語の割合)は最も汚れていた作品で 87% → 97%(Hear the Wind Sing)、86% → 94%(After Dark)へと大きく改善。前処理の良し悪しが、以降のすべての分析の品質を決めるという教訓を地で行く工程でした。
分析対象 ── 村上春樹 長編小説 英訳14作品(1979–2017)
| 出版年 | 作品(英題) | 翻訳者 | 語数 |
|---|---|---|---|
| 1979 | Hear the Wind Sing | Ted Goossen | 23,797 |
| 1980 | Pinball, 1973 | Ted Goossen | 35,223 |
| 1982 | A Wild Sheep Chase | Alfred Birnbaum | 88,533 |
| 1985 | Hard-Boiled Wonderland and the End of the World | Alfred Birnbaum | 117,558 |
| 1987 | Norwegian Wood | Jay Rubin | 121,071 |
| 1988 | Dance Dance Dance | Alfred Birnbaum | 121,121 |
| 1992 | South of the Border, West of the Sun | Philip Gabriel | 57,080 |
| 1994 | The Wind-Up Bird Chronicle | Jay Rubin | 256,569 |
| 1999 | Sputnik Sweetheart | Philip Gabriel | 63,459 |
| 2002 | Kafka on the Shore | Philip Gabriel | 176,019 |
| 2004 | After Dark | Jay Rubin | 47,305 |
| 2009 | 1Q84 | Rubin & Gabriel ※混成 | 416,683 |
| 2013 | Colorless Tsukuru Tazaki and His Years of Pilgrimage | Philip Gabriel | 85,485 |
| 2017 | Killing Commendatore | Gabriel & Goossen ※混成 | 245,114 |
合計 約185万語。『1Q84』は Rubin(BOOK 1-2)+Gabriel(BOOK 3)、『騎士団長殺し』は Gabriel+Goossen の混成訳。翻訳者は刊行版に基づく。
① 頻度分析・TF-IDF × ワードクラウド(12.4 頻度分析)
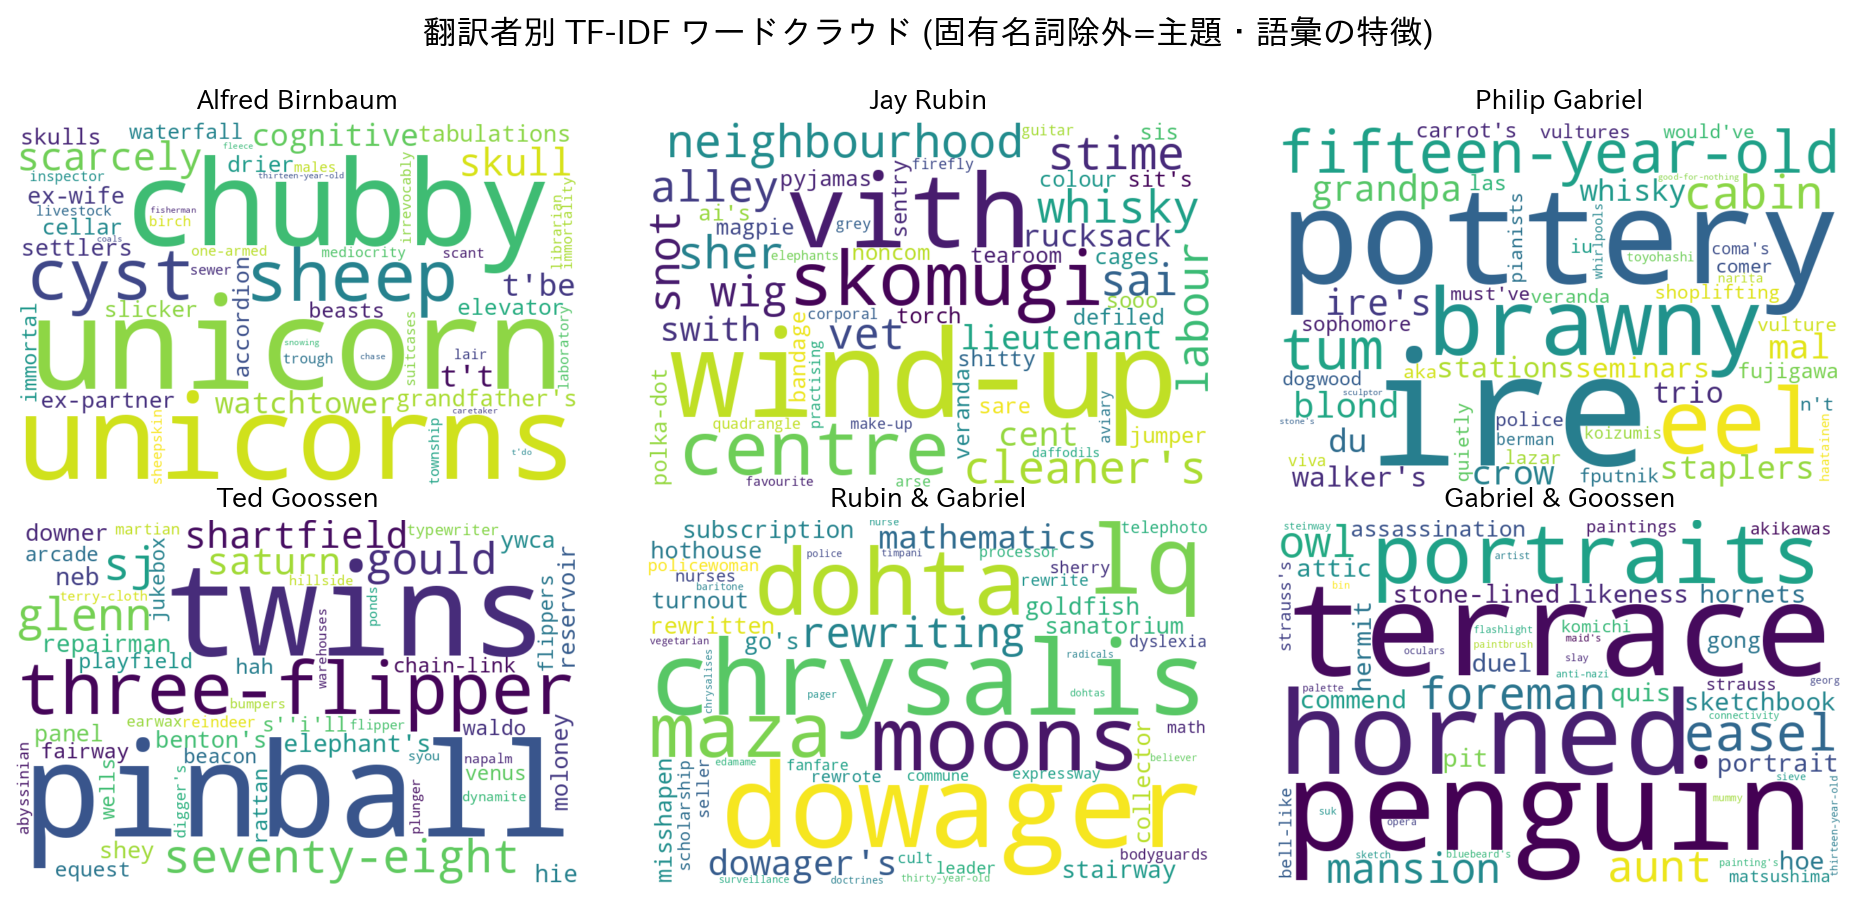
TF-IDF は「ある集団でどれだけ特徴的か」を測る指標です。各翻訳者の担当作を1つの文書とみなして特徴語を抽出すると、Birnbaum 担当作の unicorn / skull / sheep(幻想的な初期作品)、Gabriel 担当作の pottery / terrace などが浮かび上がります。ただしこの段階で見えるのは主に「担当作品の主題」の差であり、翻訳者の文体そのものの差は、後半のスタイロメトリーで切り分けます。
📖 図の読み方
語の大きさは TF-IDF スコアの高さ=その翻訳者の担当作で相対的に「特徴的」な語であることを表します(単なる高頻度語ではない点に注意)。固有名詞は除外してあるので、残るのは主題・情景・語彙の傾向です。ここで見える違いは、まだ『翻訳者の文体そのもの』ではなく、まず『担当作品が何を描いているか』を映している、と慎重に読むのが正確です。
② 単語埋め込み(SBERT)× UMAP ── 意味の地図
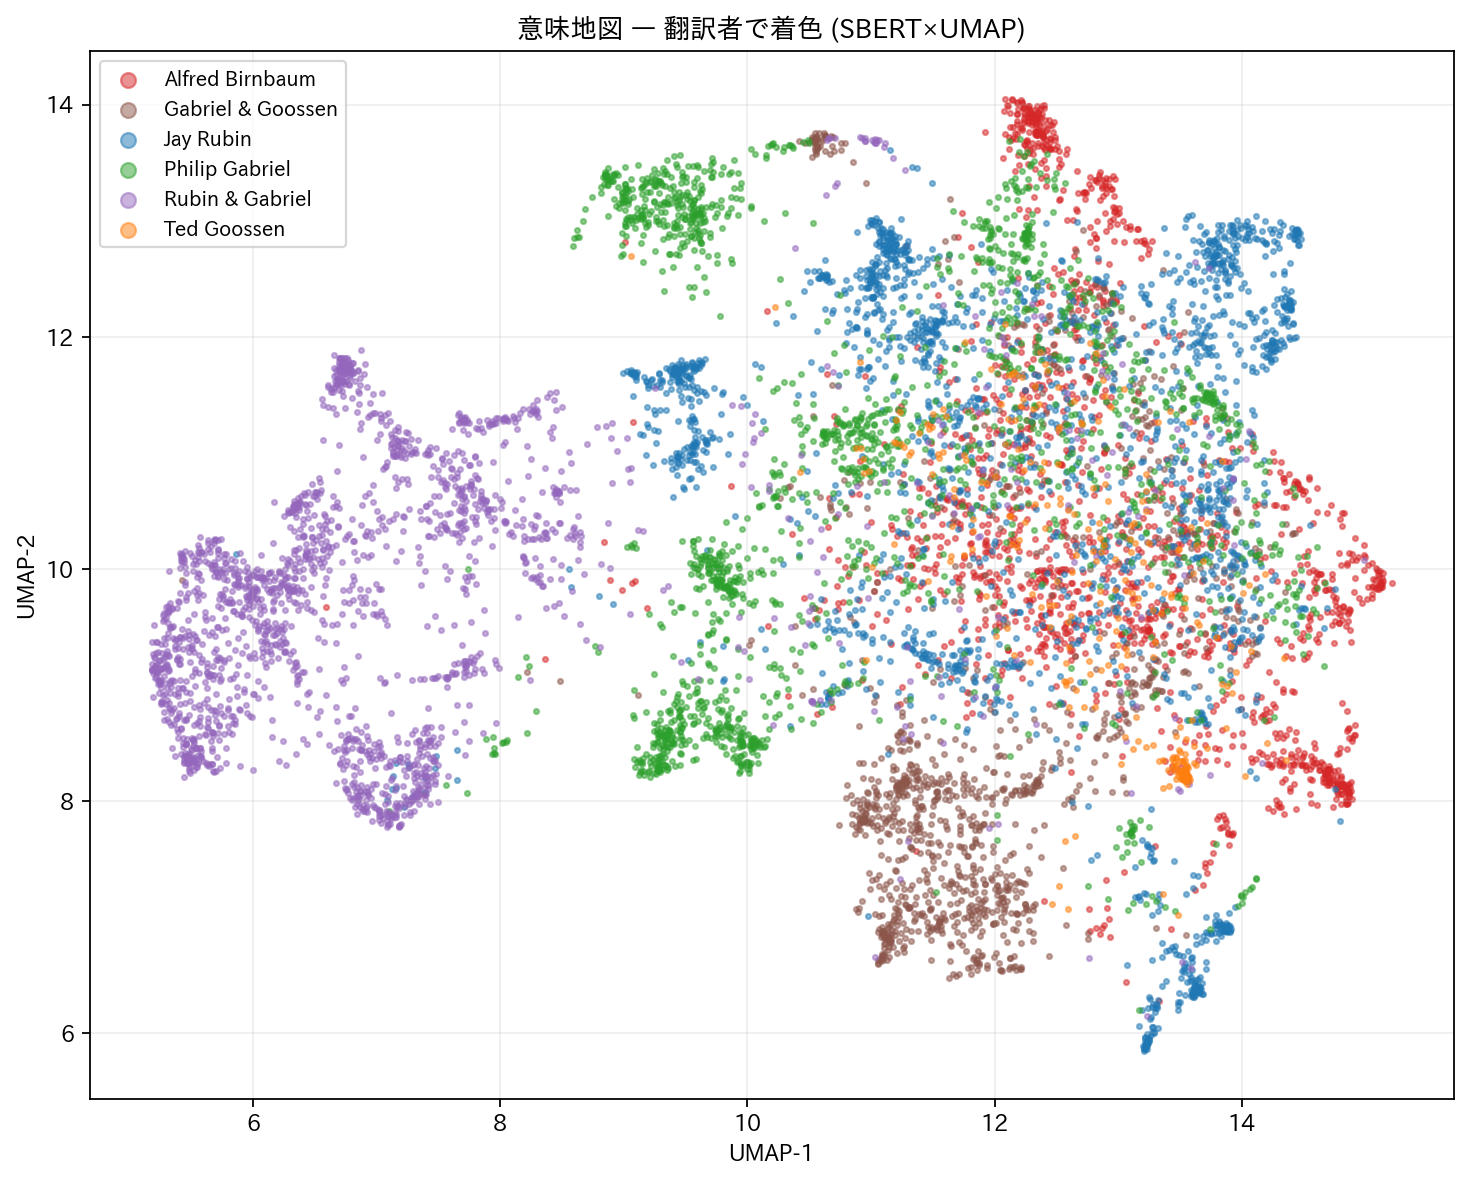
各作品を約200語のパッセージに分け、BERT 系の言語モデルで意味ベクトルに変換、UMAP で2次元に配置すると、コーパス全体の「意味地図」が描けます。Birnbaum の初期幻想作品群が左側に独立した領域を作るなど、作風の差が空間構造として現れます。下の対話的バージョンでは、点にカーソルを合わせると本文の抜粋が表示されます。
対話的 UMAP 意味地図(ズーム・ホバー操作が可能)
📖 図の読み方
1点が1つのパッセージ(約200語)。2点が近いほど『意味(内容・文体)が似ている』ことを表します。軸の数値自体に意味はなく、見るべきは「かたまり(クラスタ)」と「色の分かれ方」です。同じ色(=同じ翻訳者)の点がまとまって独自の領域を作っていれば、その翻訳者の担当作が意味空間でも他と区別できることを示します(Birnbaum の初期幻想作品が左に島を作るのがその例)。
③ トピックモデル(BERTopic)── 話題の構造
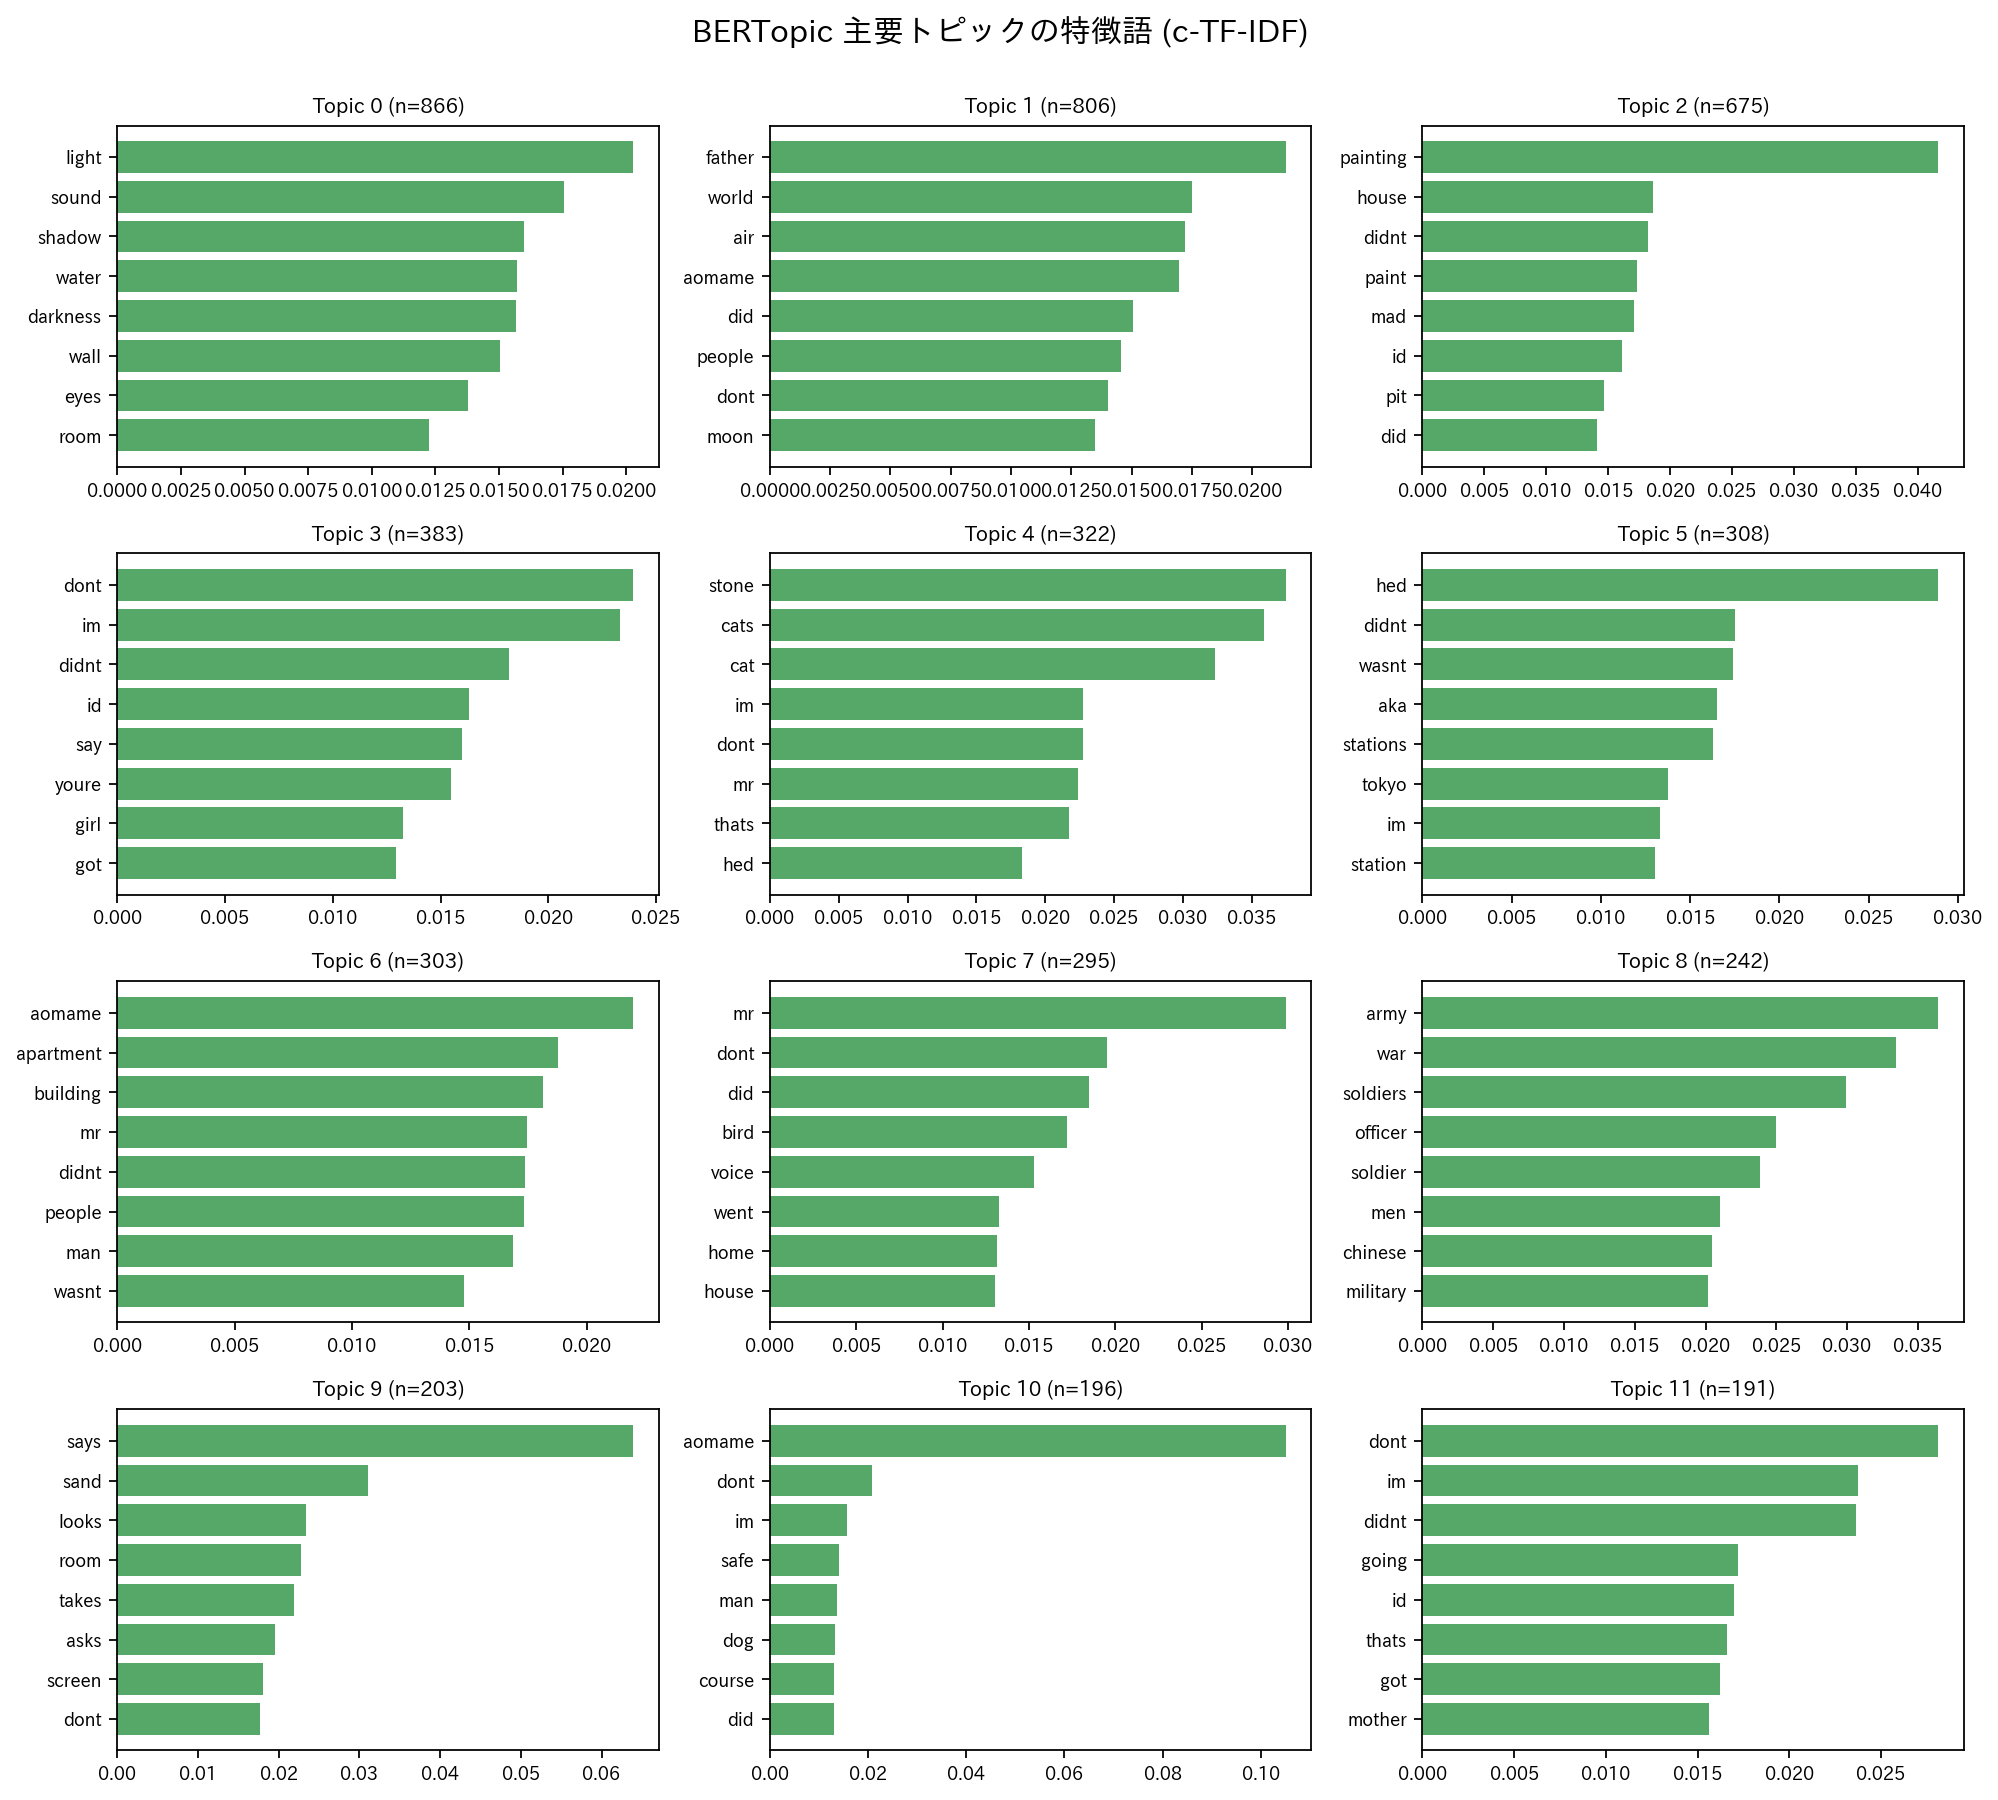
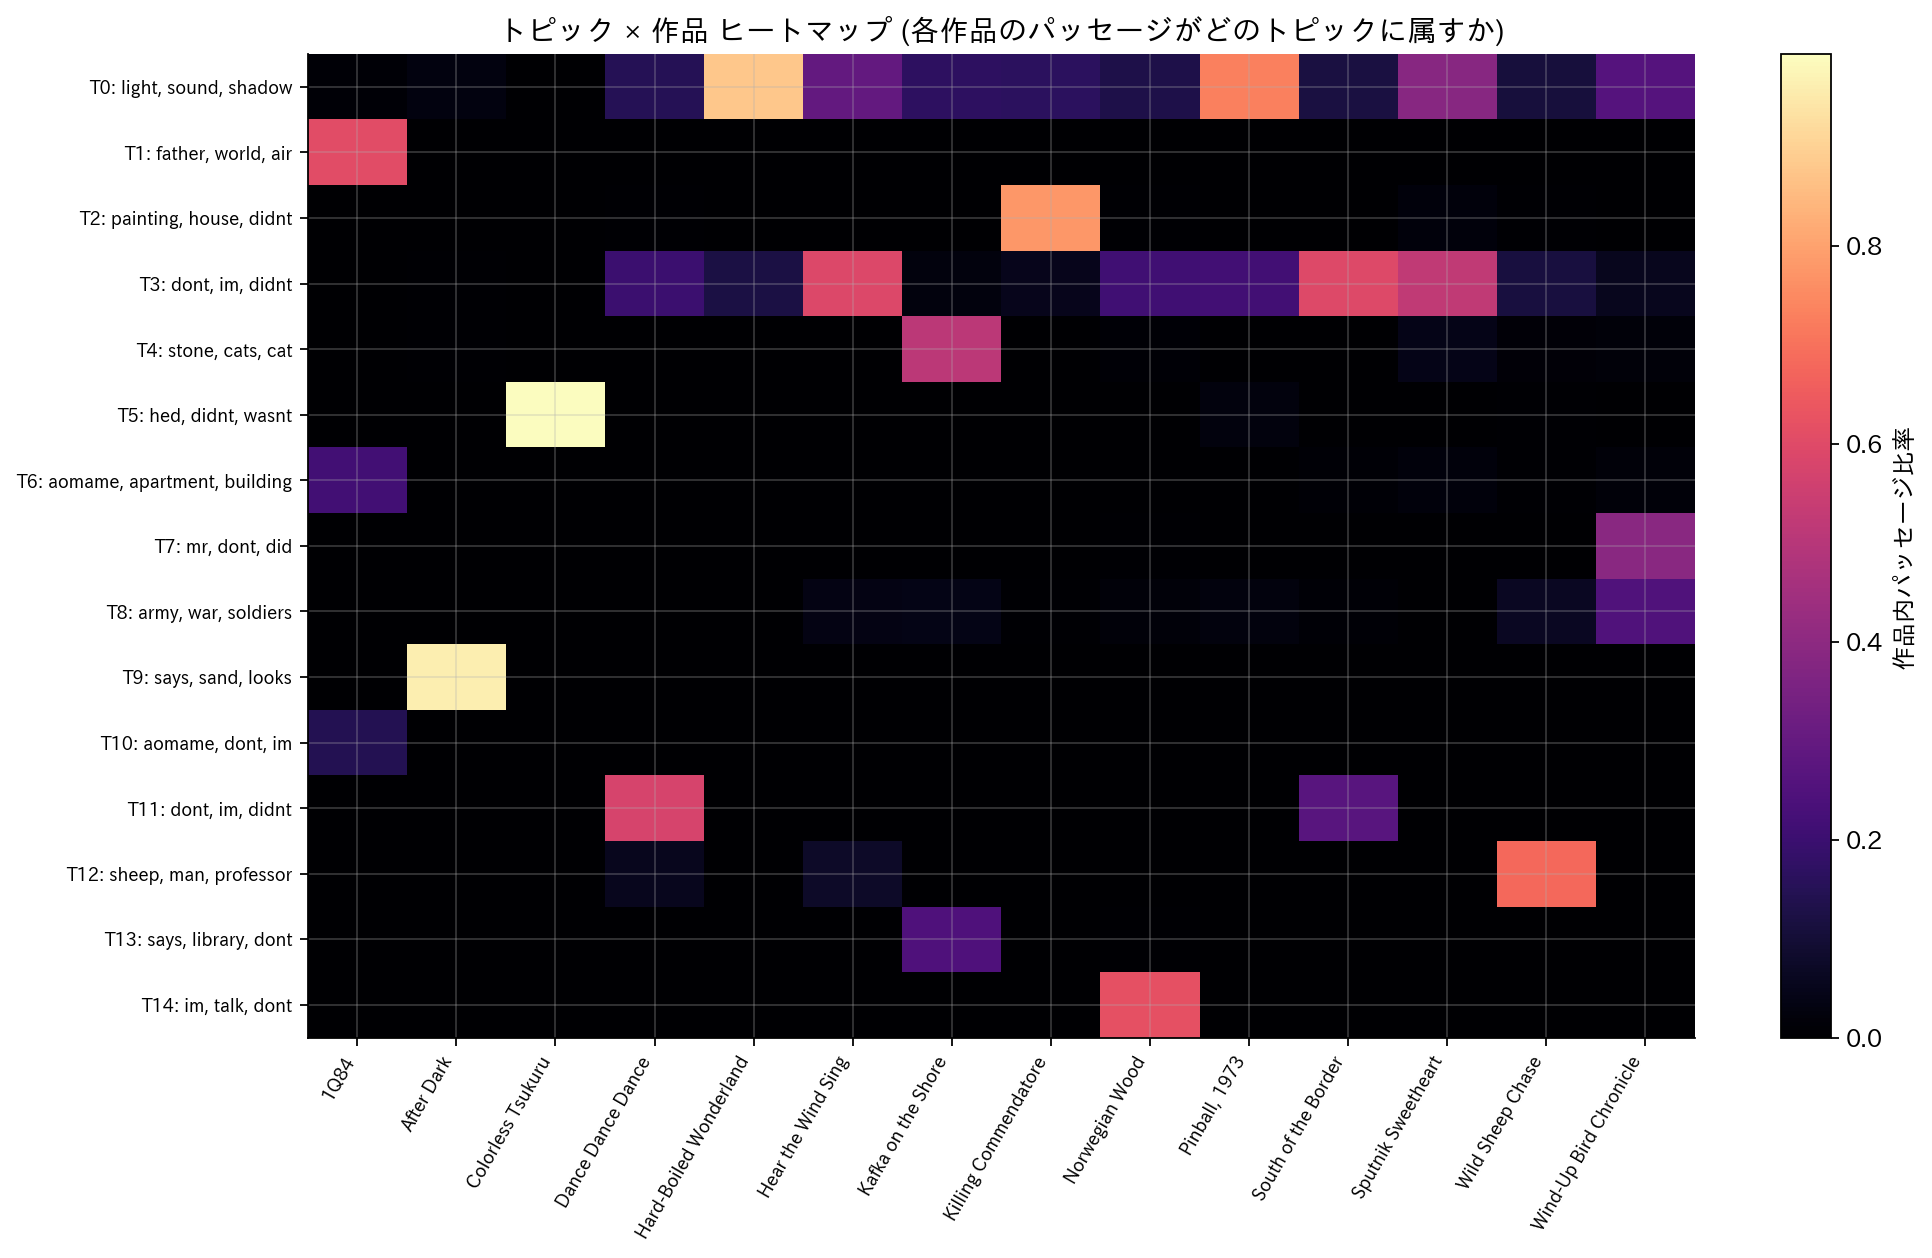
BERTopic は埋め込み+クラスタリングで話題を自動抽出します。戦争(army/soldiers/chinese =『ねじまき鳥クロニクル』のノモンハン)、絵画(painting/studio =『騎士団長殺し』)、異界(cat/stone/well)、家族など村上的主題が話題単位で立ち上がります。とりわけ says/asks を核とするトピックは現在形で書かれた『After Dark』に偏在し、原文の時制選択が英訳の語彙分布に刻まれていることが分かります。
📖 図の読み方
左の図は各トピックを代表する語(c-TF-IDF が高い語)。語の並びを見て『これは戦争の話題』『これは絵画の話題』と人間がラベルを与えます。右のヒートマップは縦がトピック・横が作品で、セルが濃いほど『その作品にそのトピックのパッセージが多い』ことを示します。横の一行を見れば作品の主題構成が、縦の一列を見ればある話題がどの作品に偏っているかが読めます。
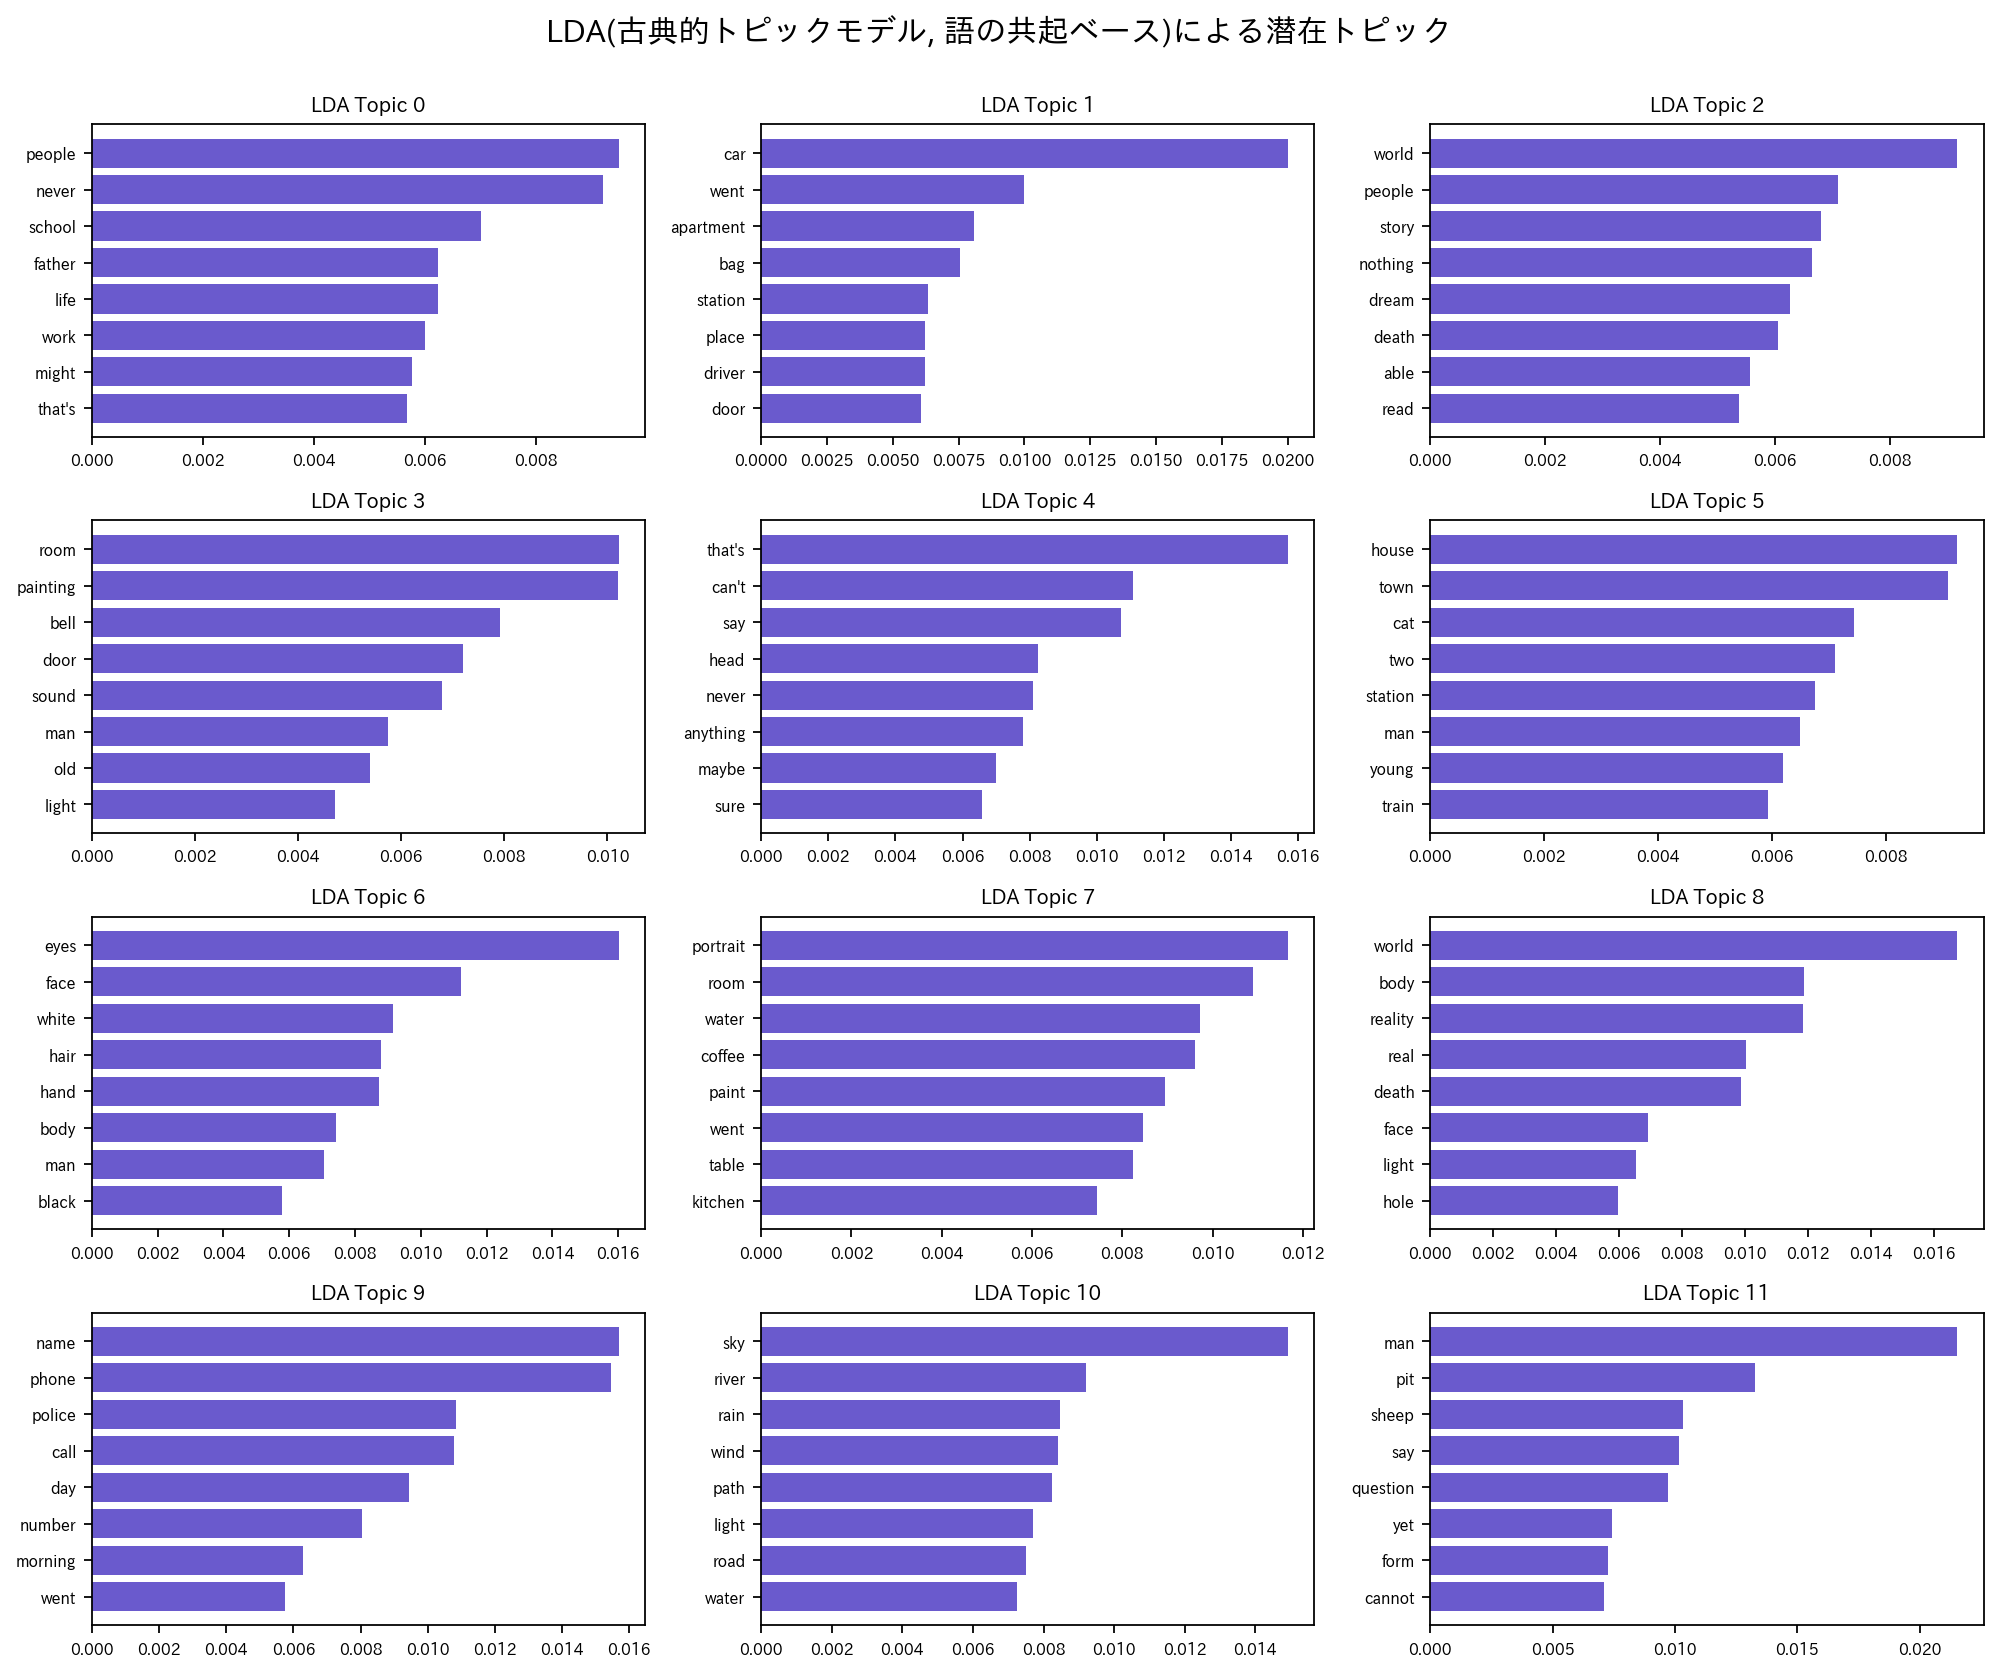
古典的な LDA(語の共起のみに基づくトピックモデル)でも、世界・夢・死(異界)、絵画、身体・感覚、自然(空・川・雨)といった同種の主題が浮かび上がります。埋め込みベースの BERTopic とおおむね整合し、二つの手法を突き合わせることで「村上的主題」の頑健さを確認できます。
★ 本事例のハイライト:スタイロメトリーと「翻訳者の指紋」(12.4 文体計量・機械学習)
ここからが「翻訳の特徴」の核心です。内容語ではなく機能語(the, of, would… )の使い方という、主題に左右されにくい特徴に注目します。
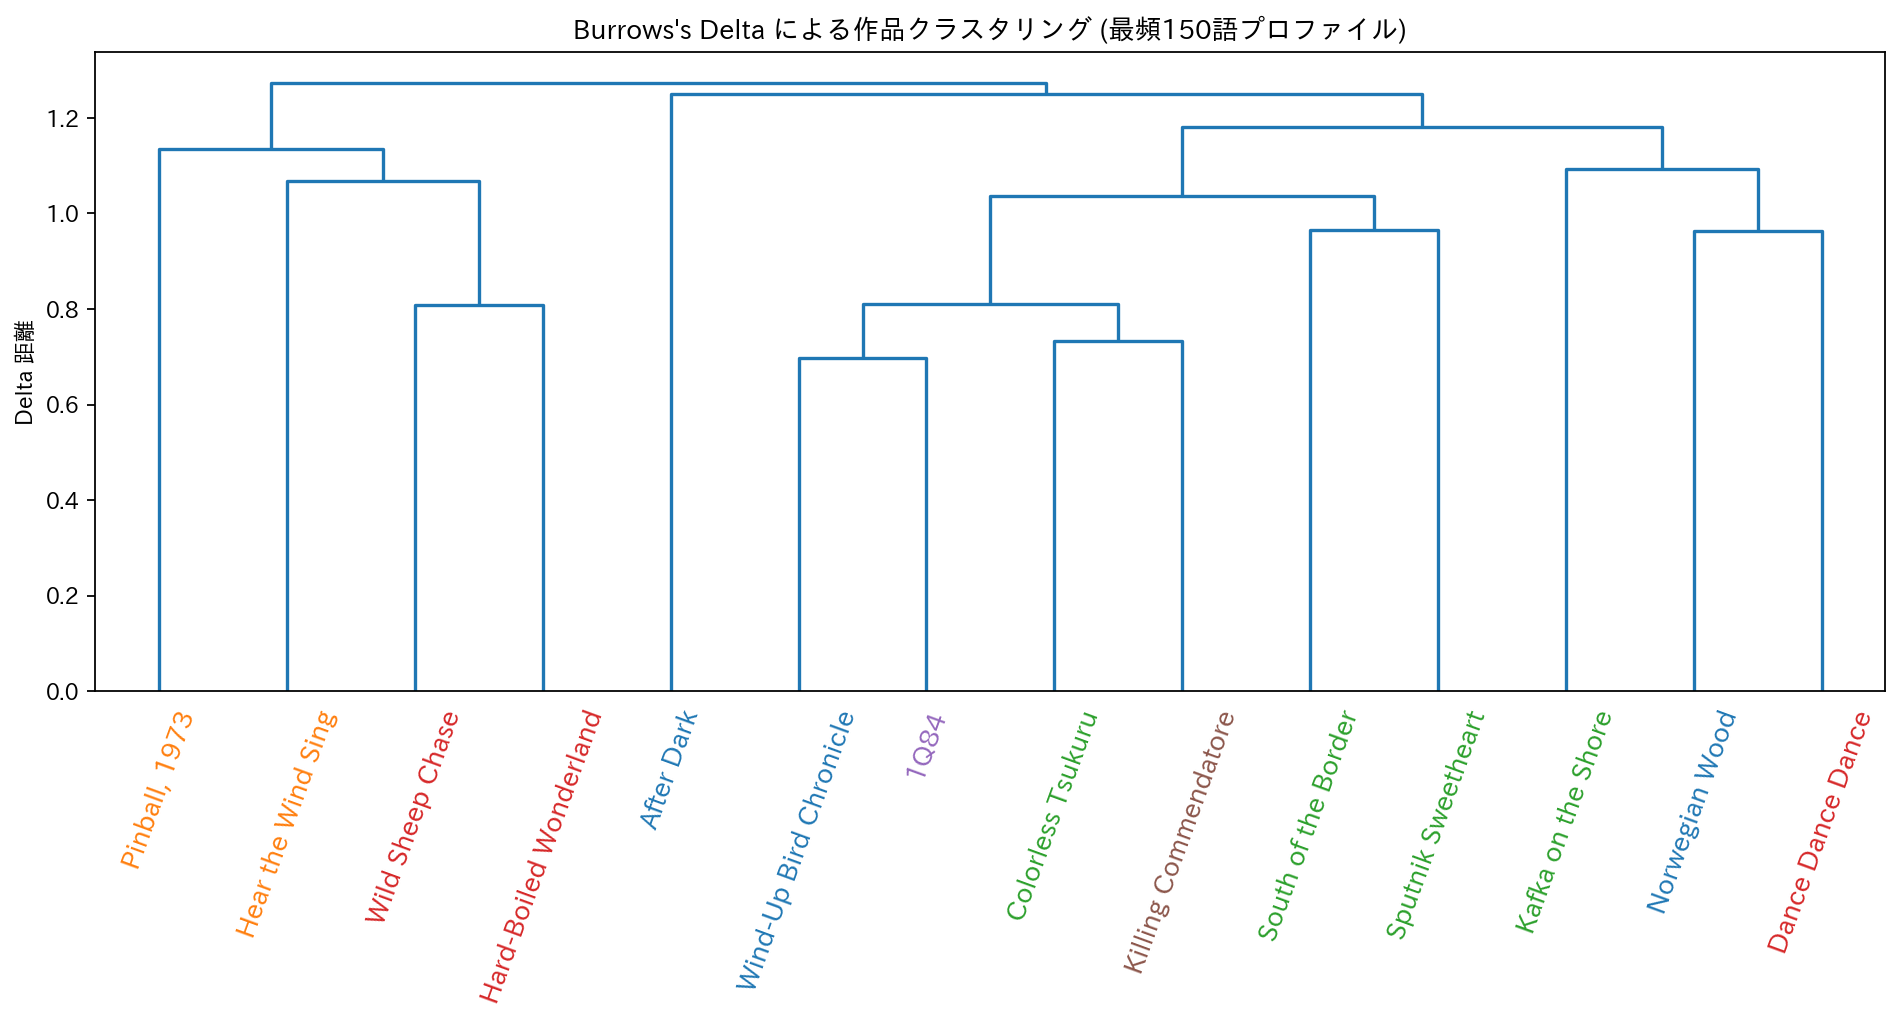
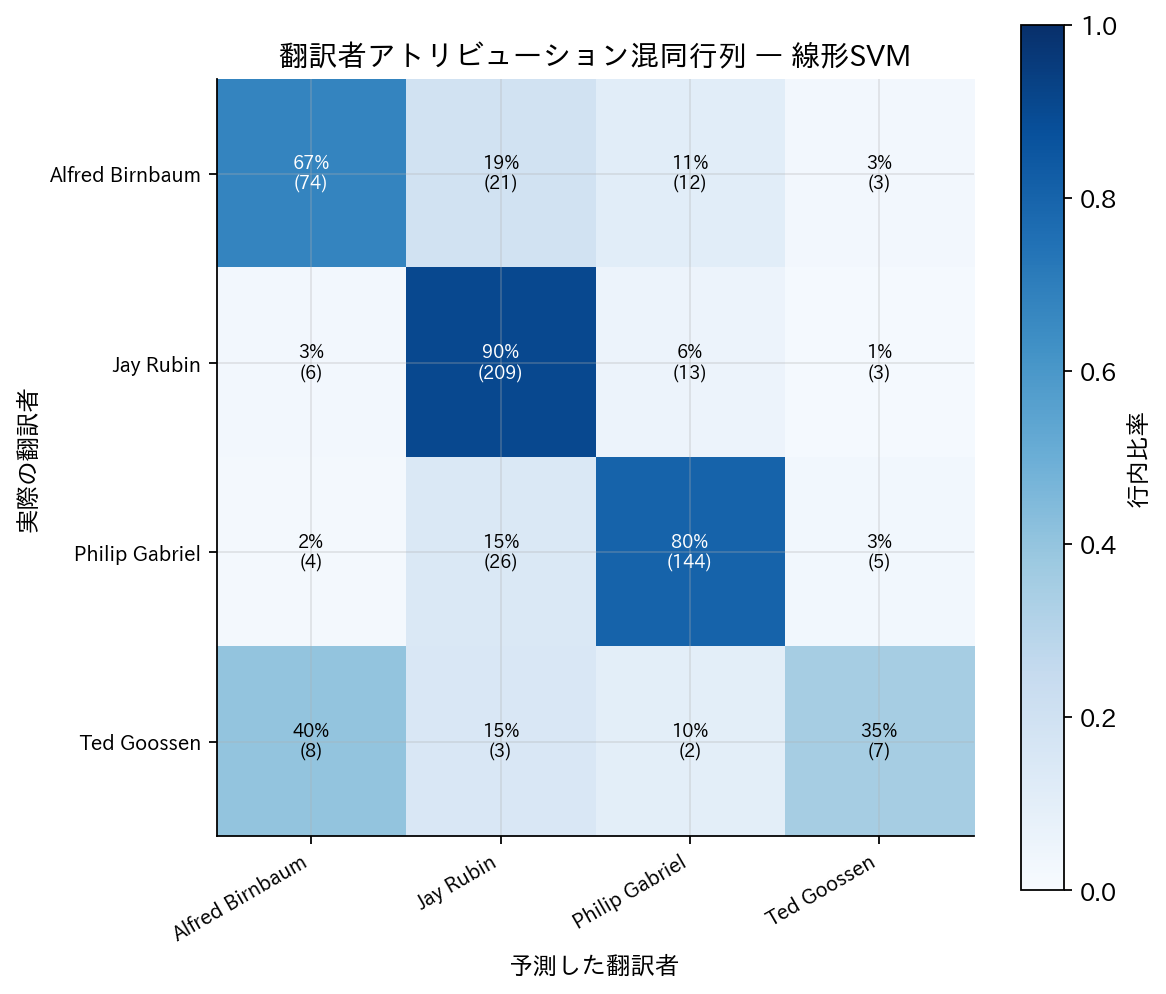
最頻語プロファイルの距離(Burrows's Delta)で作品を階層クラスタリングすると、部分的に翻訳者ごとのまとまりが現れます。さらに踏み込んで、「作品の内容を一度も見ずに、文体だけで翻訳者を当てられるか」を機械学習(線形SVM)で検証しました。テスト作品を学習から完全に除外する Leave-One-Out 交差検証で、作品単位 約93%(14作品中13作品)の精度で翻訳者を同定できました(偶然なら25%)。
📖 図の読み方
左のデンドログラム(樹形図)は、文体が近い作品ほど低い位置で枝が合流します。ラベルの色は翻訳者で、同じ色が低い位置でまとまるほど翻訳者の文体的まとまりが強いと読めます。右の混同行列は、行が「実際の翻訳者」、列が「分類器の予測」。対角線(左上→右下)が濃いほど正解が多く、対角から外れたセルは取り違えやすさ(例:Goossen を Birnbaum と誤りやすい)を示します。
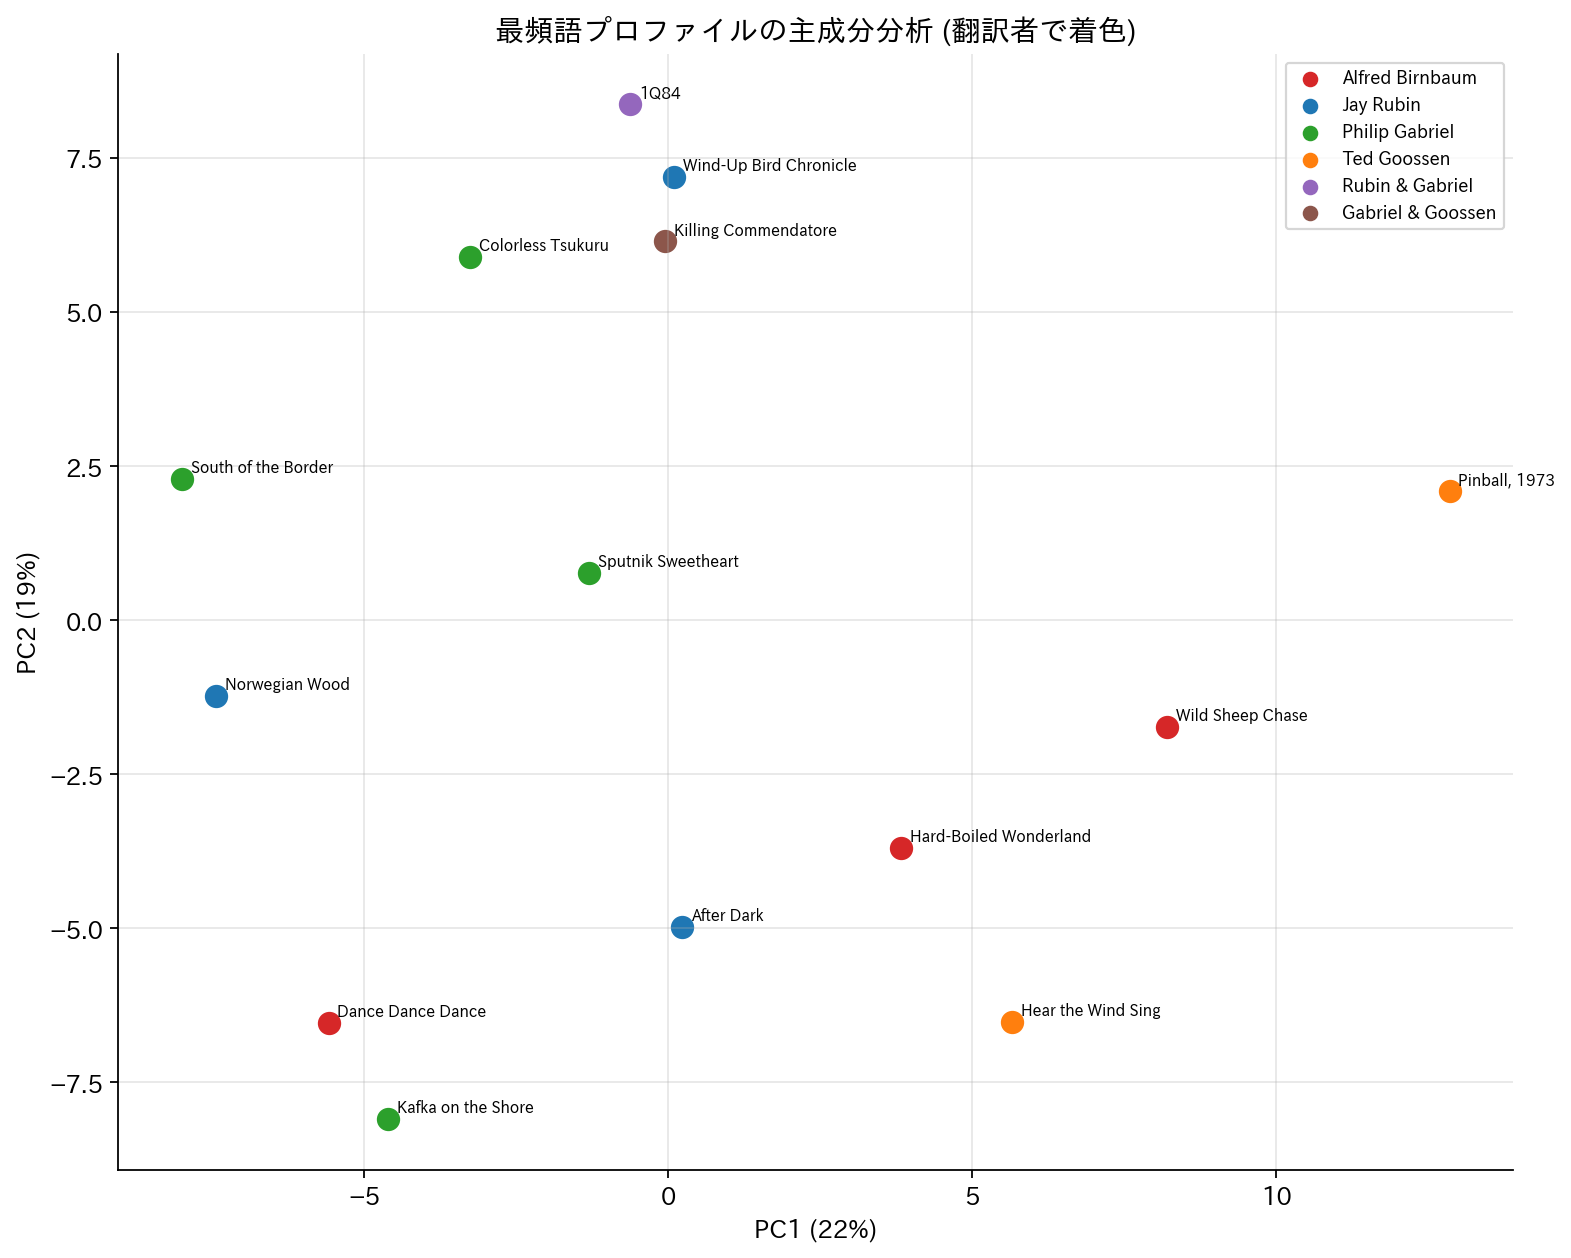
主成分分析でも同様の構造が見えます。第1主成分(横軸)は初期作(Birnbaum・Goossen, 右側)と後期作(Gabriel・Rubin, 左側)をおおむね分けており、機能語の使い方に翻訳者・時代の構造があることが確認できます。
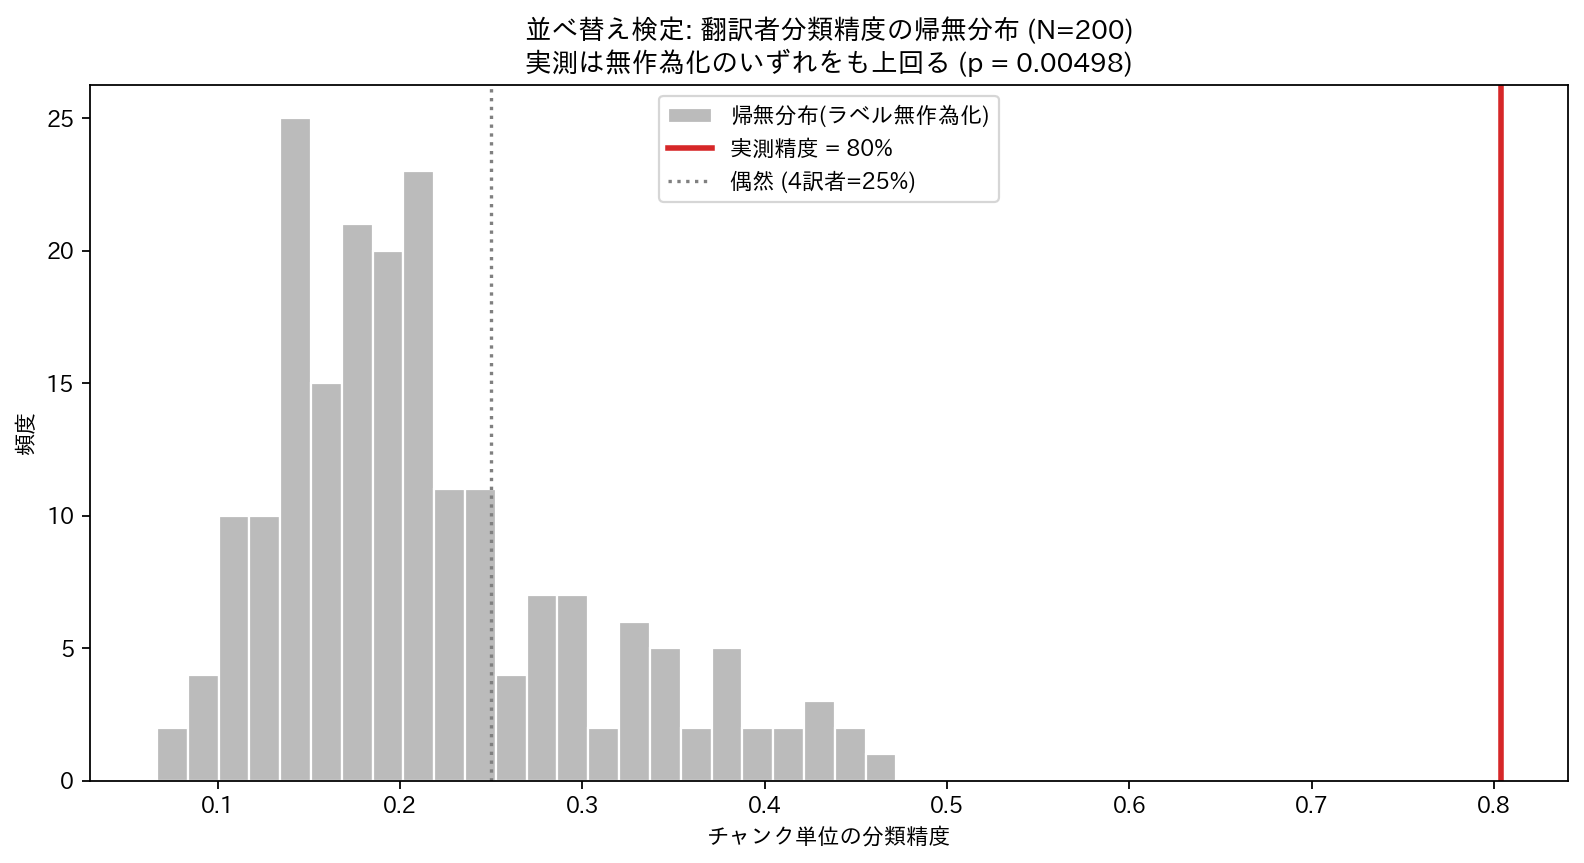
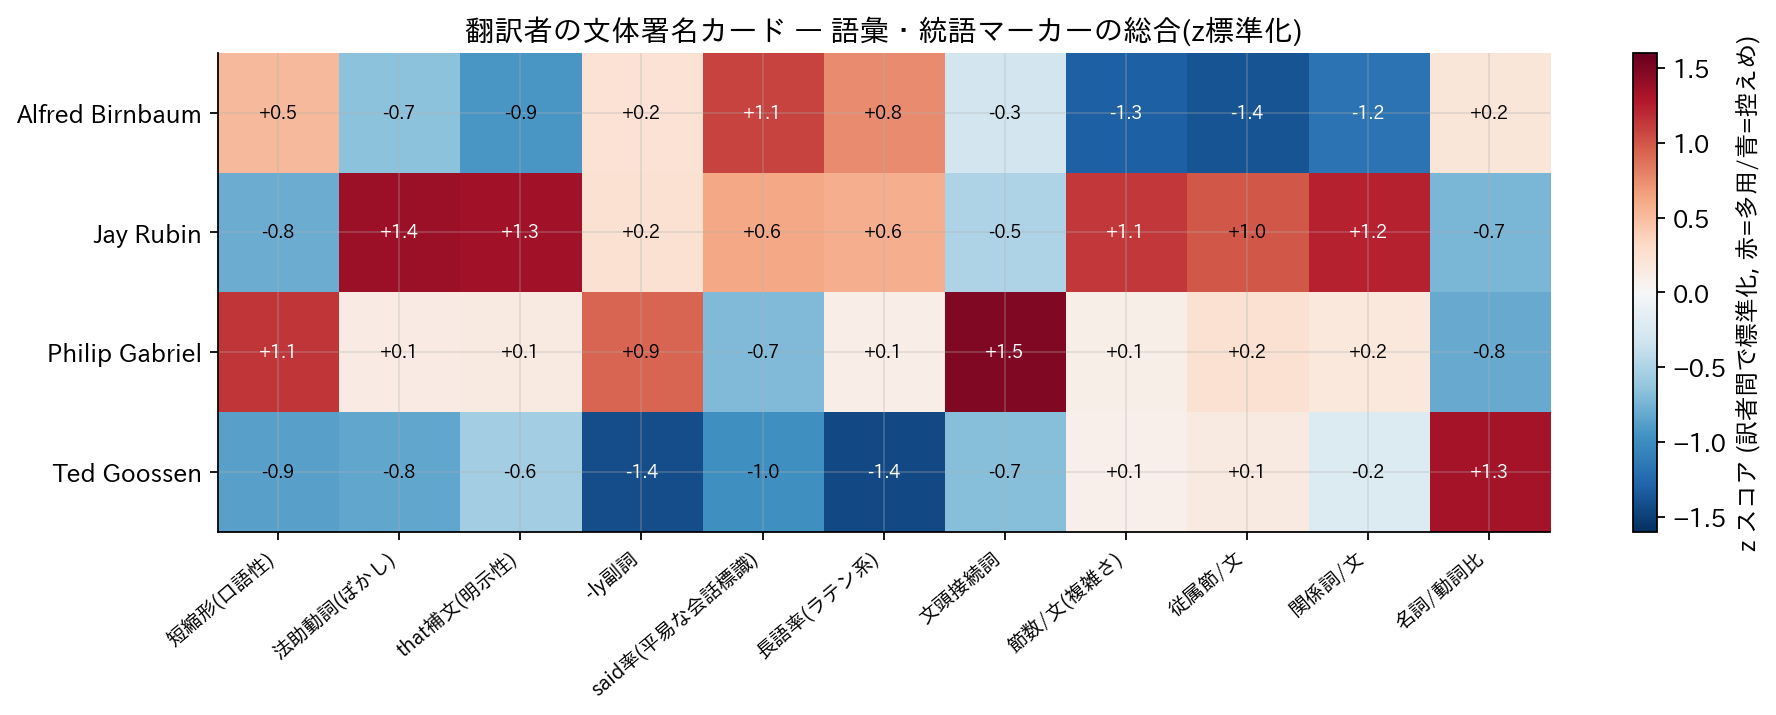
「サンプル(作品数)が少ないだけでは?」という懸念には並べ替え検定で答えます。翻訳者ラベルをランダムに入れ替えても 47% までしか精度が出ず、実測80%との差は統計的に有意でした(p = 0.005)。そして指紋の中身も特定できました:
Jay Rubin
フォーマルで明示的・構文的に複雑。法助動詞・that 補文・従属節・関係詞が多い。
Philip Gabriel
口語的。短縮形・-ly 副詞・文頭の And/But が多い。
Alfred Birnbaum
簡潔・プレーン。短い文、会話標識は said が中心。
語彙と構文という独立した2系列が同じ結論を指す点が重要です。原文(村上の日本語)が同一作家のものである以上、これらの差の相当部分は「翻訳者の選択」に帰せられます。これは 12.4 で学んだ「スタイロメトリー」と「機械学習による分類」を組み合わせ、さらに統計的検定で頑健性を確かめた実例です。
📖 図の読み方
並べ替え検定(左)の灰色の山は「翻訳者ラベルを無作為に貼り替えたとき偶然出る精度」の分布、赤い縦線が実際の精度です。赤線が灰色の山から大きく右に離れているほど、結果は偶然では説明できない(有意)と読みます。署名カード(右)は行が翻訳者・列が文体指標で、赤いほど相対的に多用・青いほど控えめ。一行を横に眺めると、その翻訳者の「個性のパターン」が一目で分かります(例:Rubin の行は複雑性・形式性の指標が一様に赤い)。
指紋を「具体的な数値」で見る ── 語彙と構文の収束
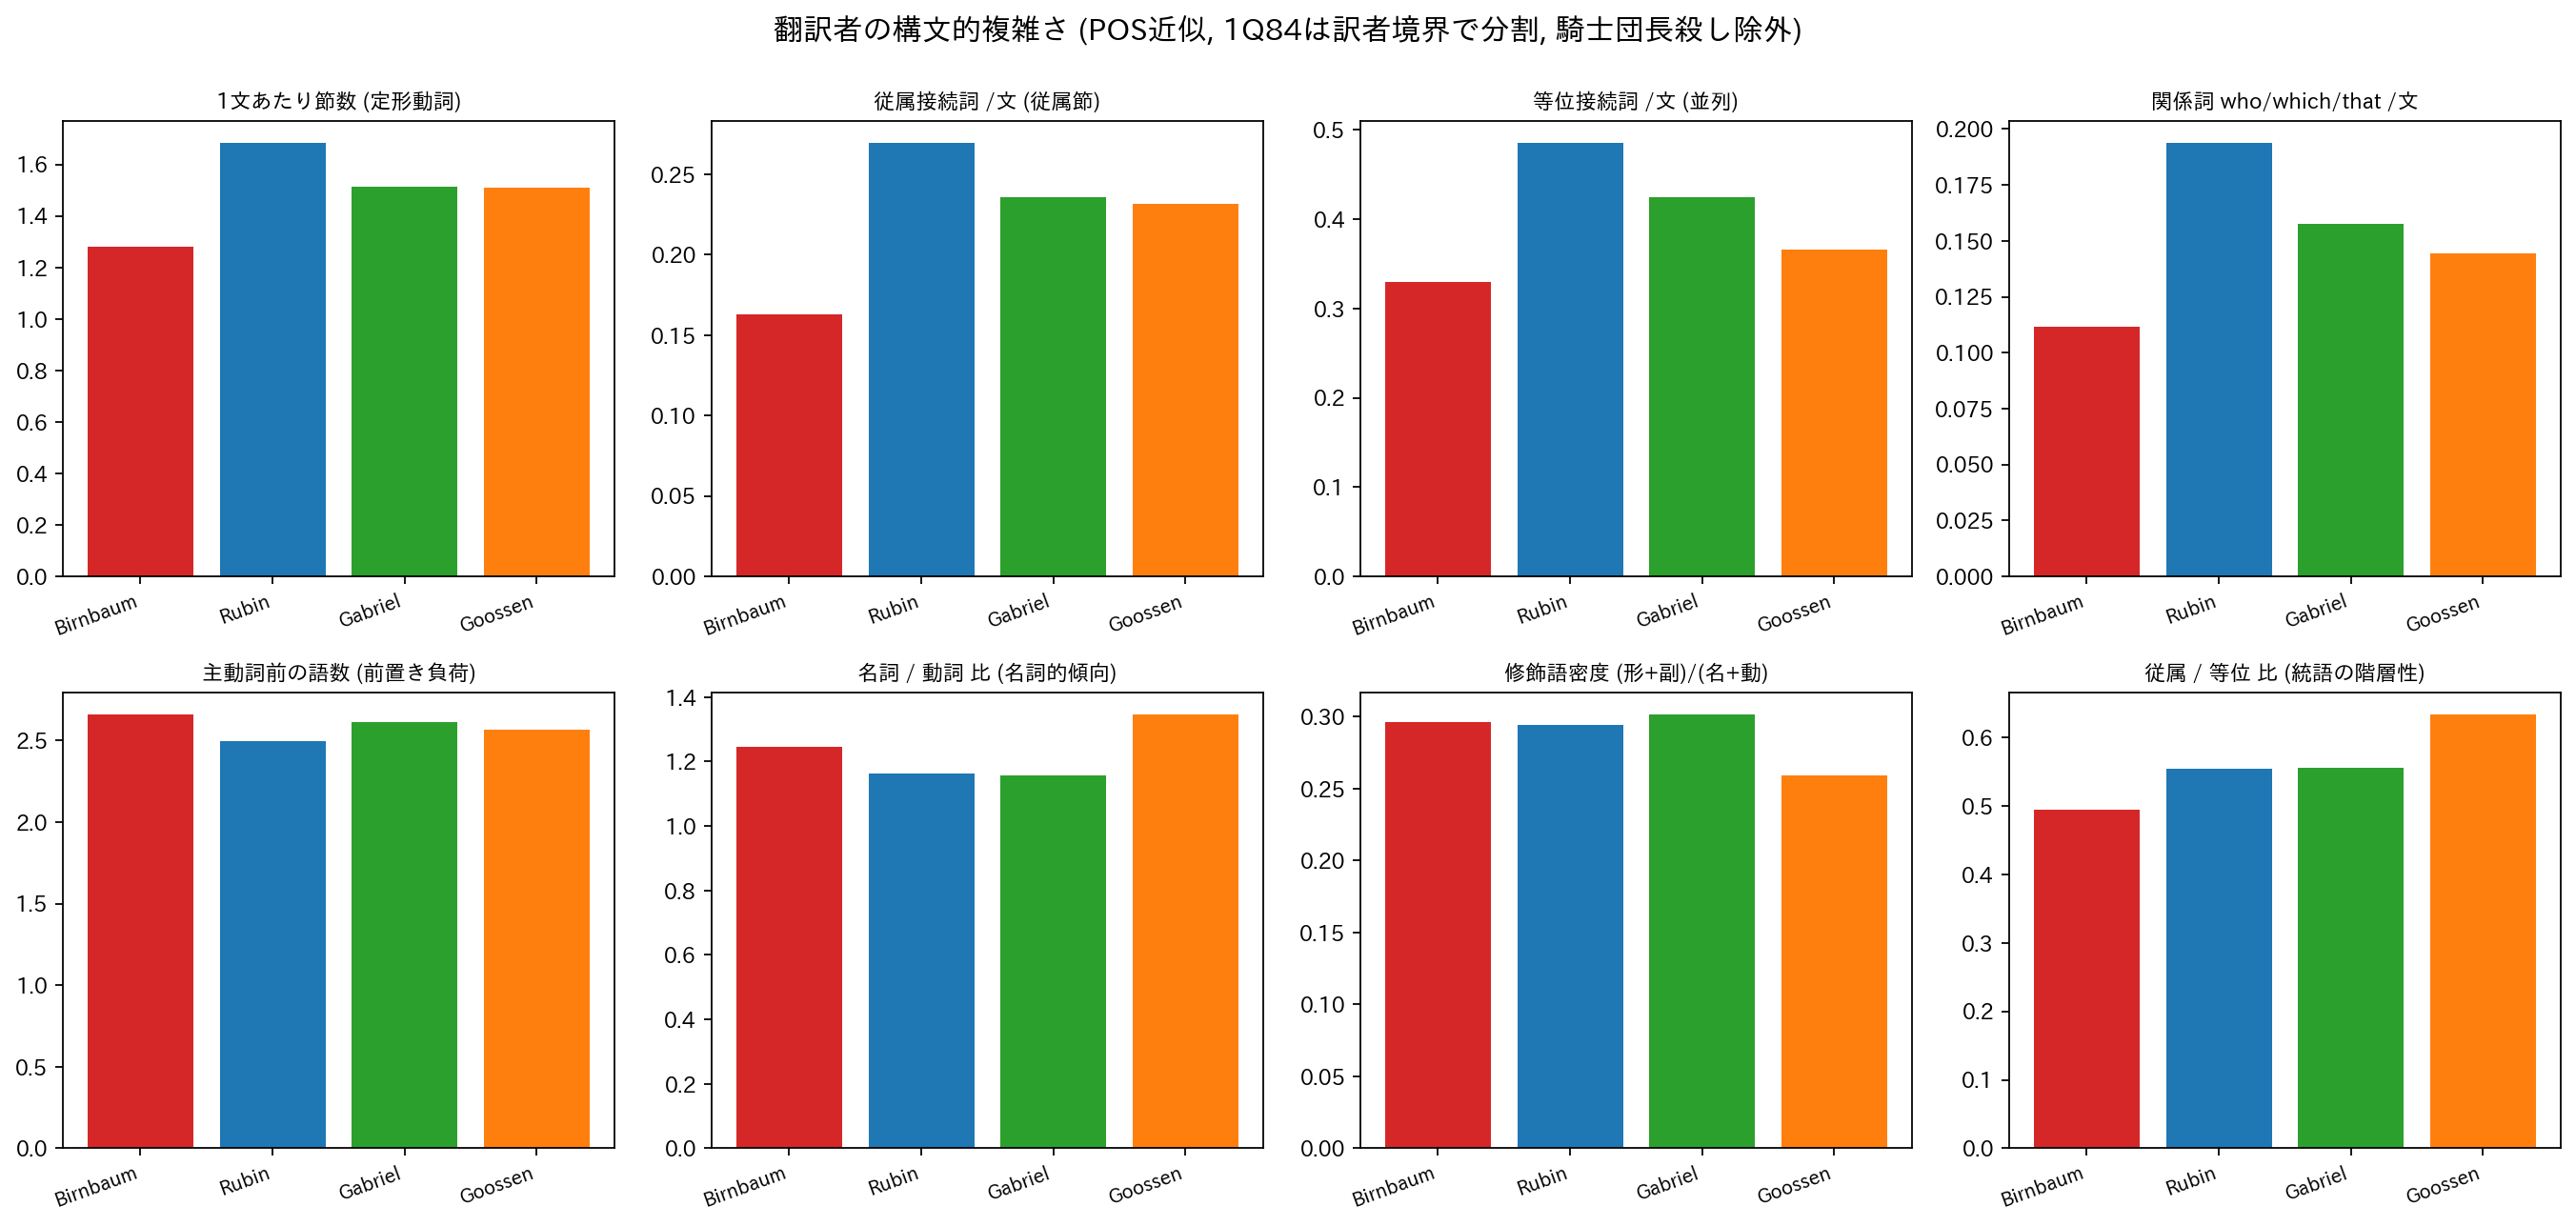
📖 図の読み方
各パネルは1文あたりの節数・従属節・関係詞などの平均値。棒が高い翻訳者ほどその構文要素を多く使う=文が複雑だと読みます。
具体的な数値で見る翻訳者差
- 平均文長:Birnbaum 9.8語(最短・簡潔)↔ Rubin 11.9語・Gabriel 11.1語。
- 1文あたりの節数(構文の複雑さ):Birnbaum 1.28(最少)↔ Rubin 1.69(最多)。語彙だけでなく構文でも Rubin が複雑・Birnbaum が簡潔。
- 綴り・語選択:Rubin は英国綴りの towards・neighbourhood、過去完了 had を相対的に多用(keyness で検出)。同じ原作でも訳者の言語的背景がにじみます。
- 句読点:セミコロンは Goossen 0.90 ↔ Rubin 0.49(千語あたり)など、細部の好みにも差。
語彙(機能語・綴り)と構文(節・従属)という独立した観点が「Rubin=複雑/Birnbaum=簡潔」という同じ結論を指すことが、結果の信頼性を高めています。
さらなる文体計量手法 ── Zeta・語彙多様性・文字n-gram・PCAローディング
文体計量学の定番手法をさらに重ね、指紋の確かさを多角的に確かめます。
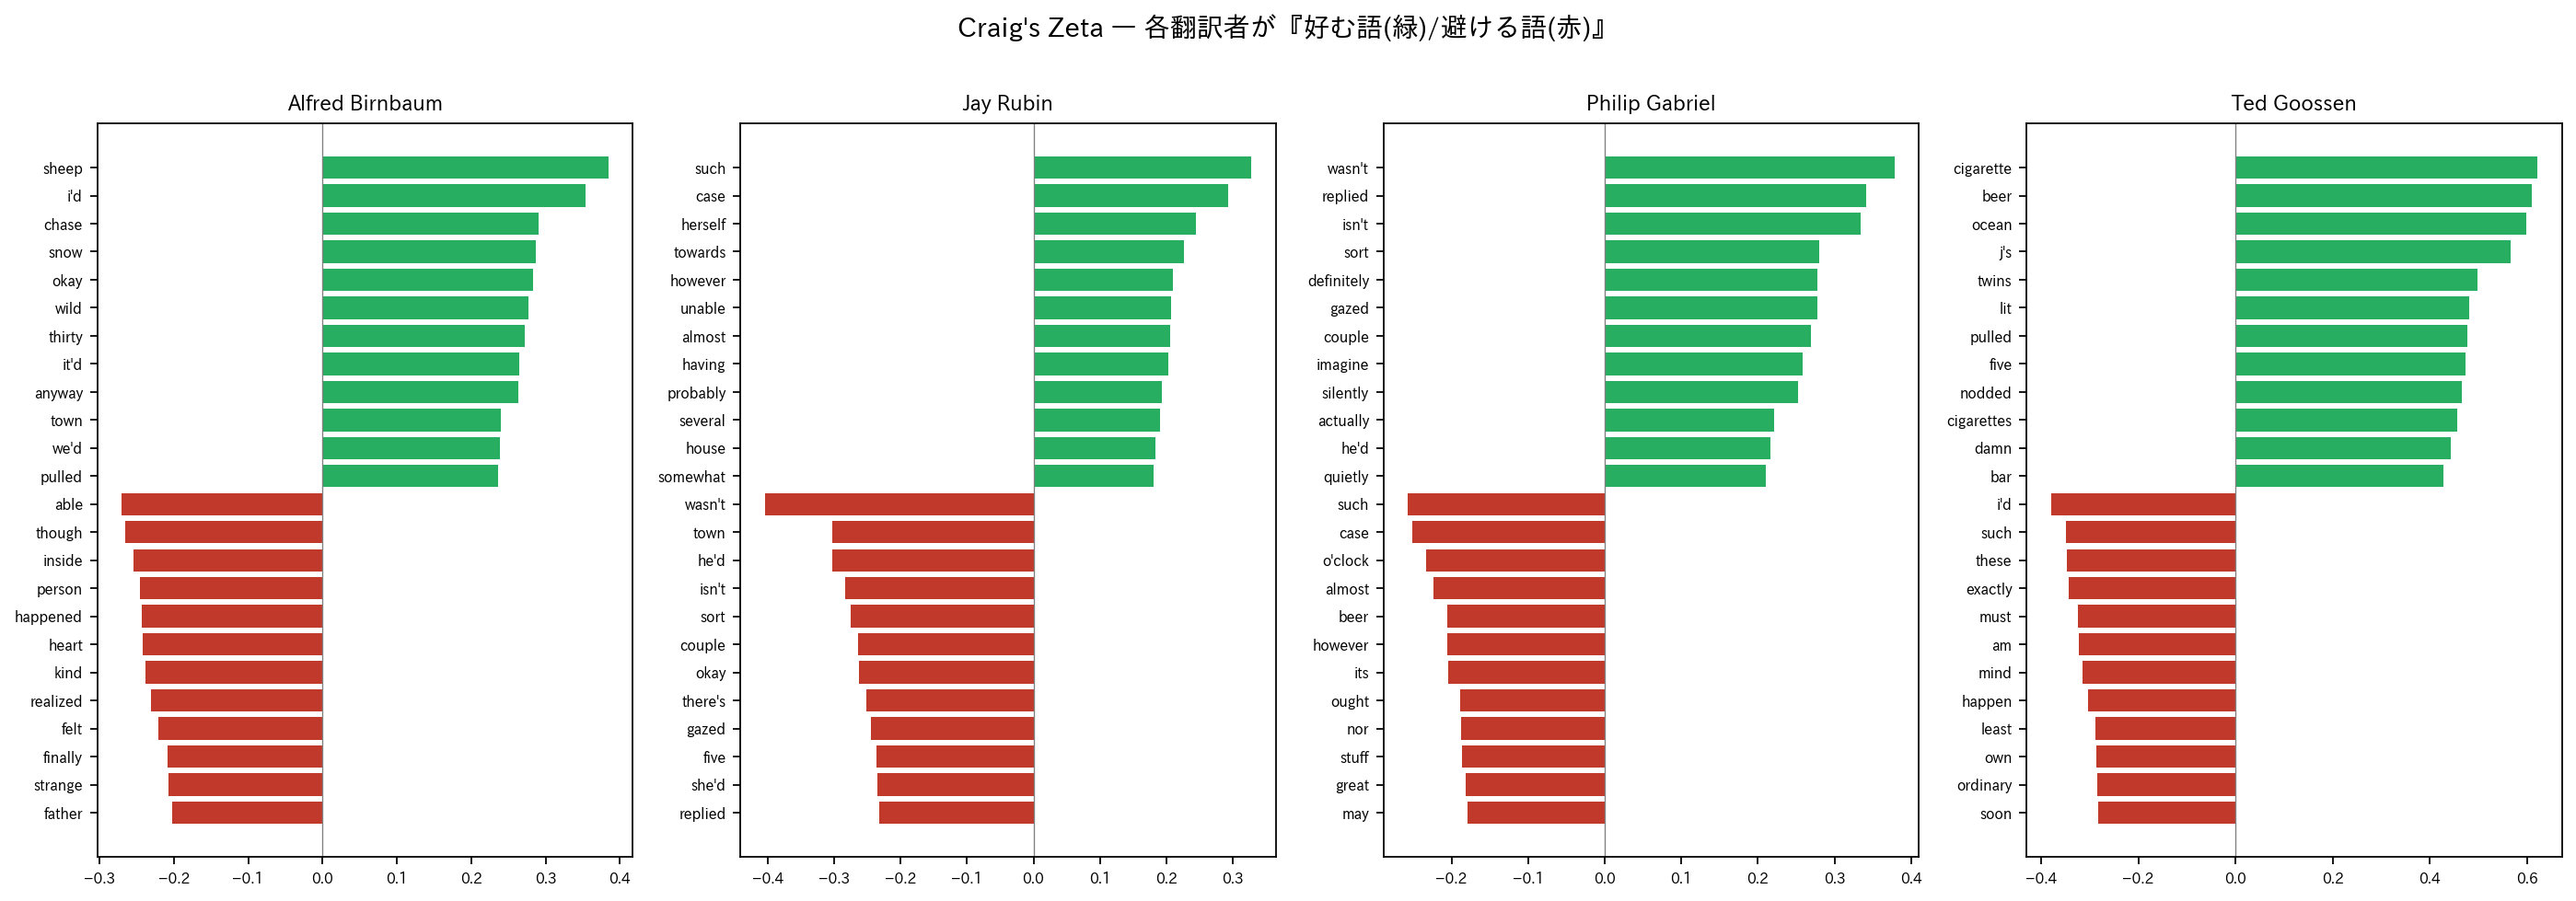
📖 図の読み方
Craig's Zeta は、ある翻訳者の「好む語(緑)/避ける語(赤)」を、語が出現するチャンクの割合の差で測ります。Rubin は such / however / towards / having など形式的・接続的な語を好む傾向が出ており、4.6 の署名と一致します。
📖 図の読み方
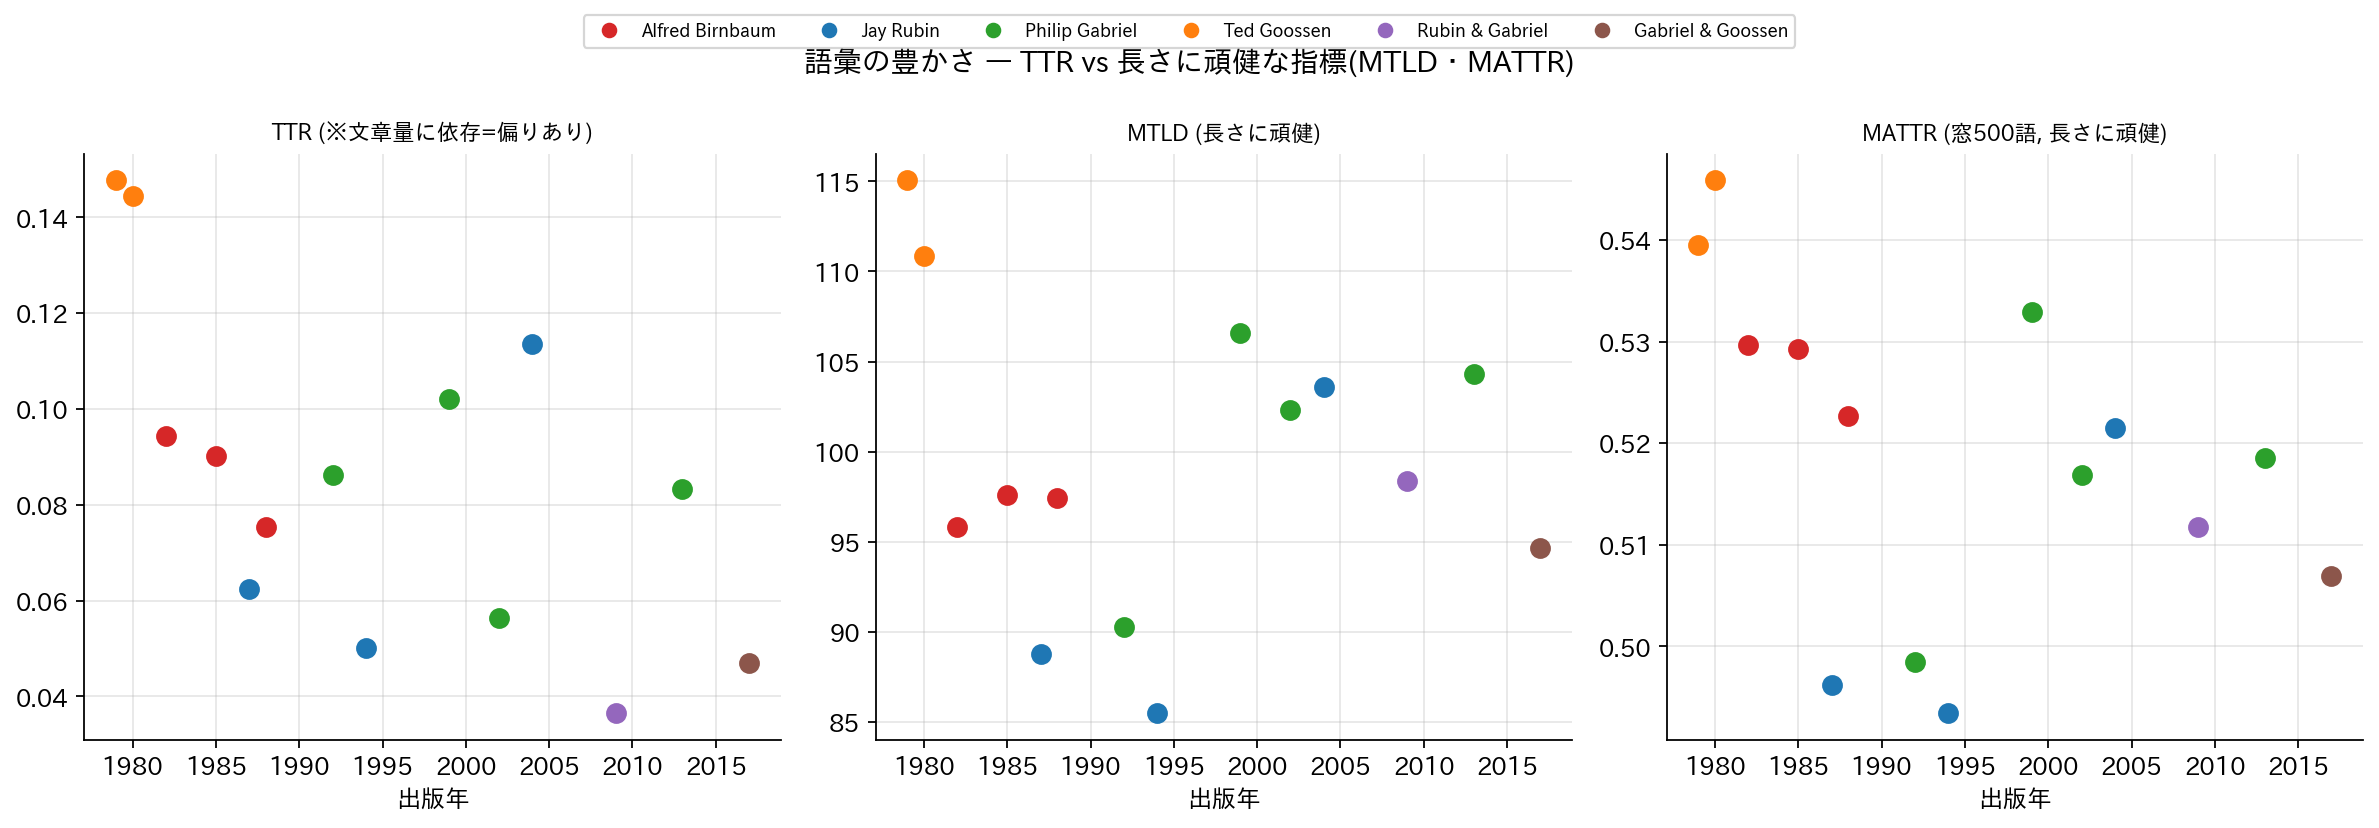
TTR は文章量に依存して偏るため、長さに頑健な MTLD・MATTR を併用します。点が高いほど語彙が多様。これで見ると Rubin は相対的に語彙の反復がやや多く(MTLD低め)、一定した語彙統制がうかがえます。
📖 図の読み方
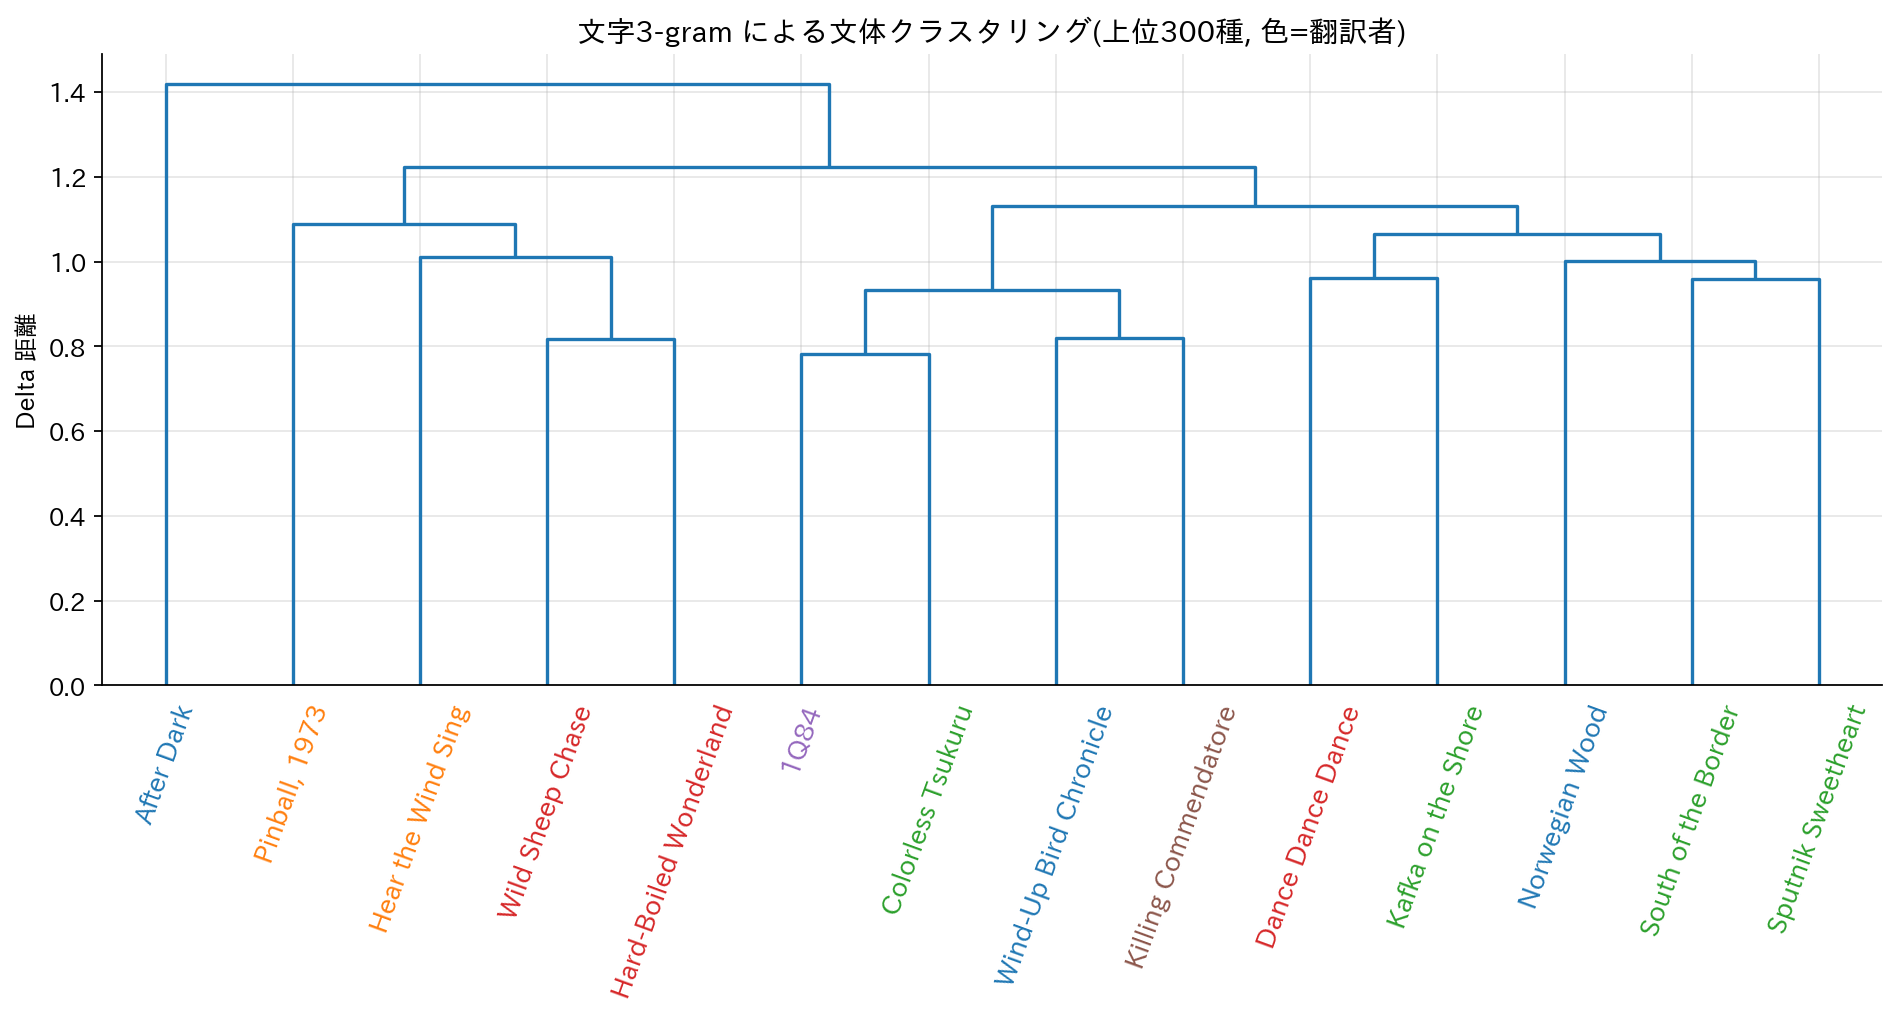
単語ではなく文字3-gram(綴り・語尾・句読点の癖)で測っても、初期作(Birnbaum/Goossen)がまとまるなど、単語 Delta と似た構造が再現されます。サブ単語のレベルでも翻訳者の癖が現れる、という傍証です。
📖 図の読み方
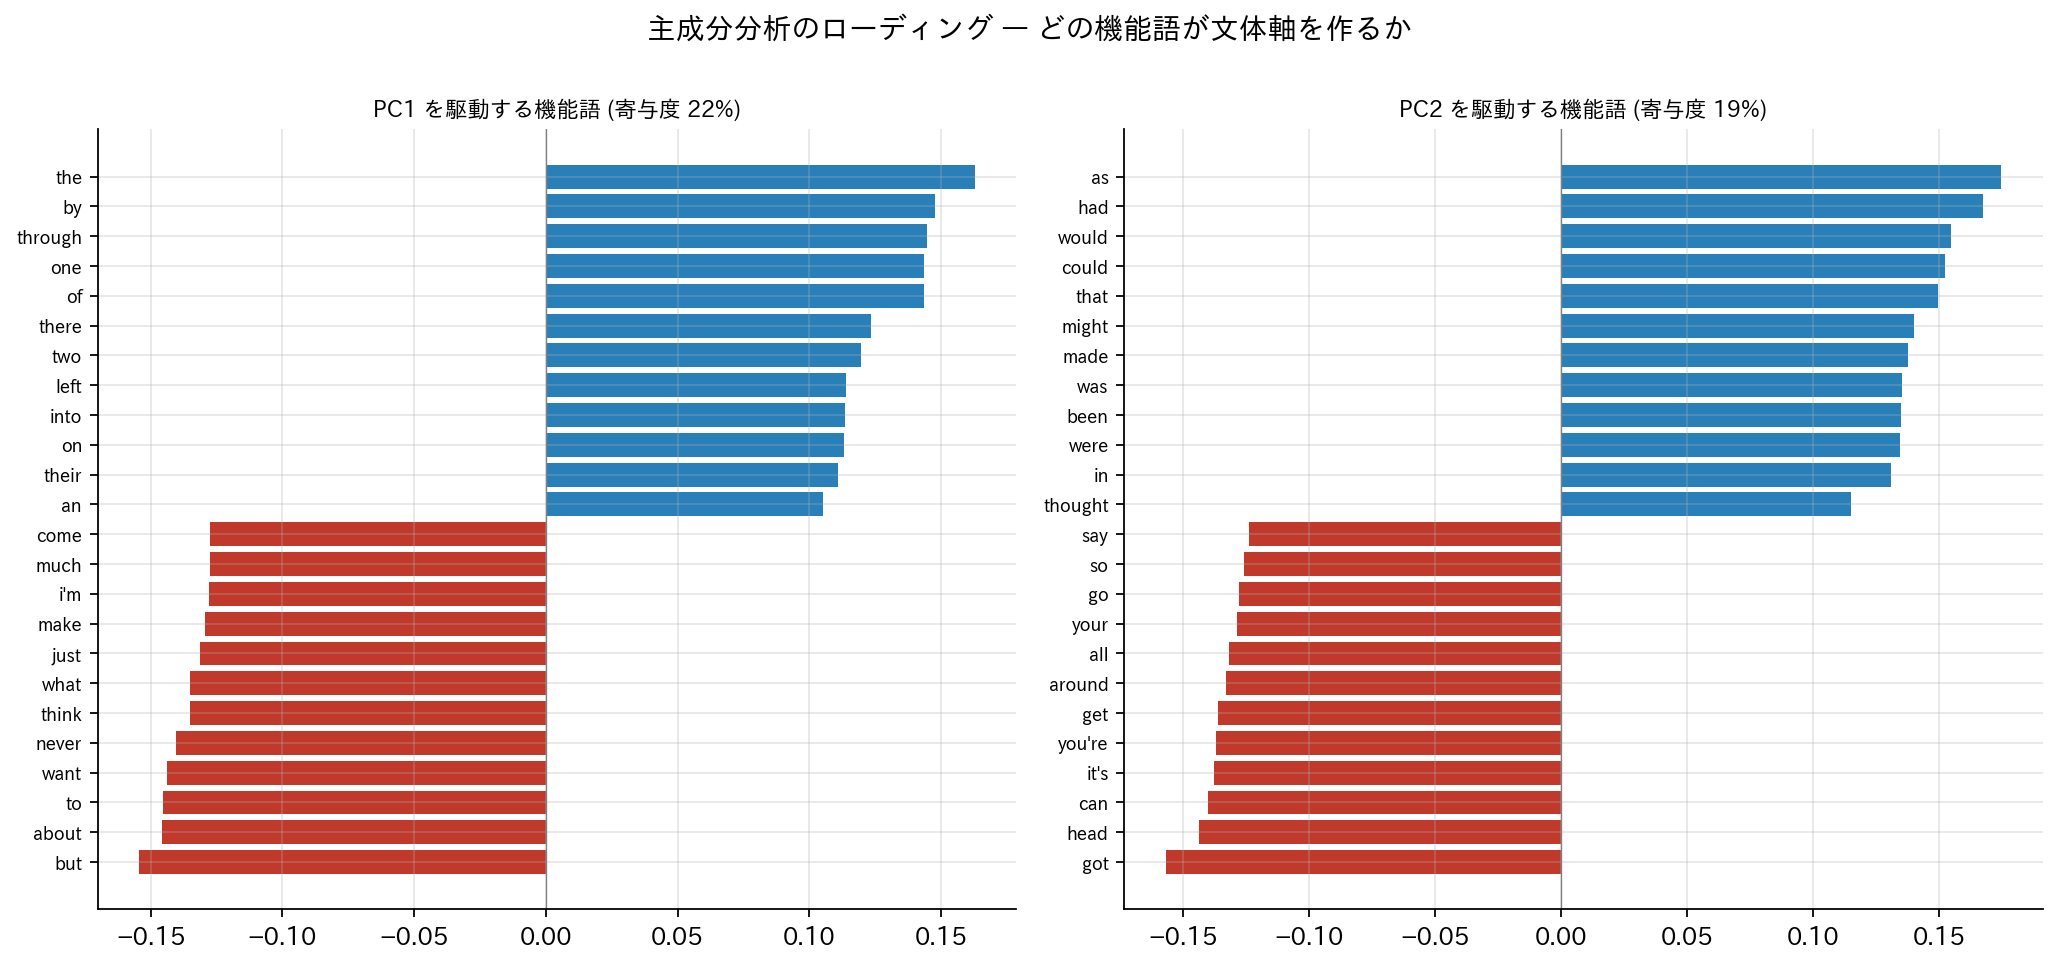
PCA のローディングは、どの機能語が文体軸を駆動するかを示します。第1主成分は the / of / through(説明的・形式)対 but / about / i'm(口語・一人称)、第2主成分は had / would / could(複雑な過去・叙述)対 say / got / it's(即時・口語)。これが「Rubin=形式・複雑/Gabriel・Birnbaum=口語」の正体です。
④ 感情分析・モチーフ・登場人物ネットワーク(12.4 感情分析・ネットワーク分析)
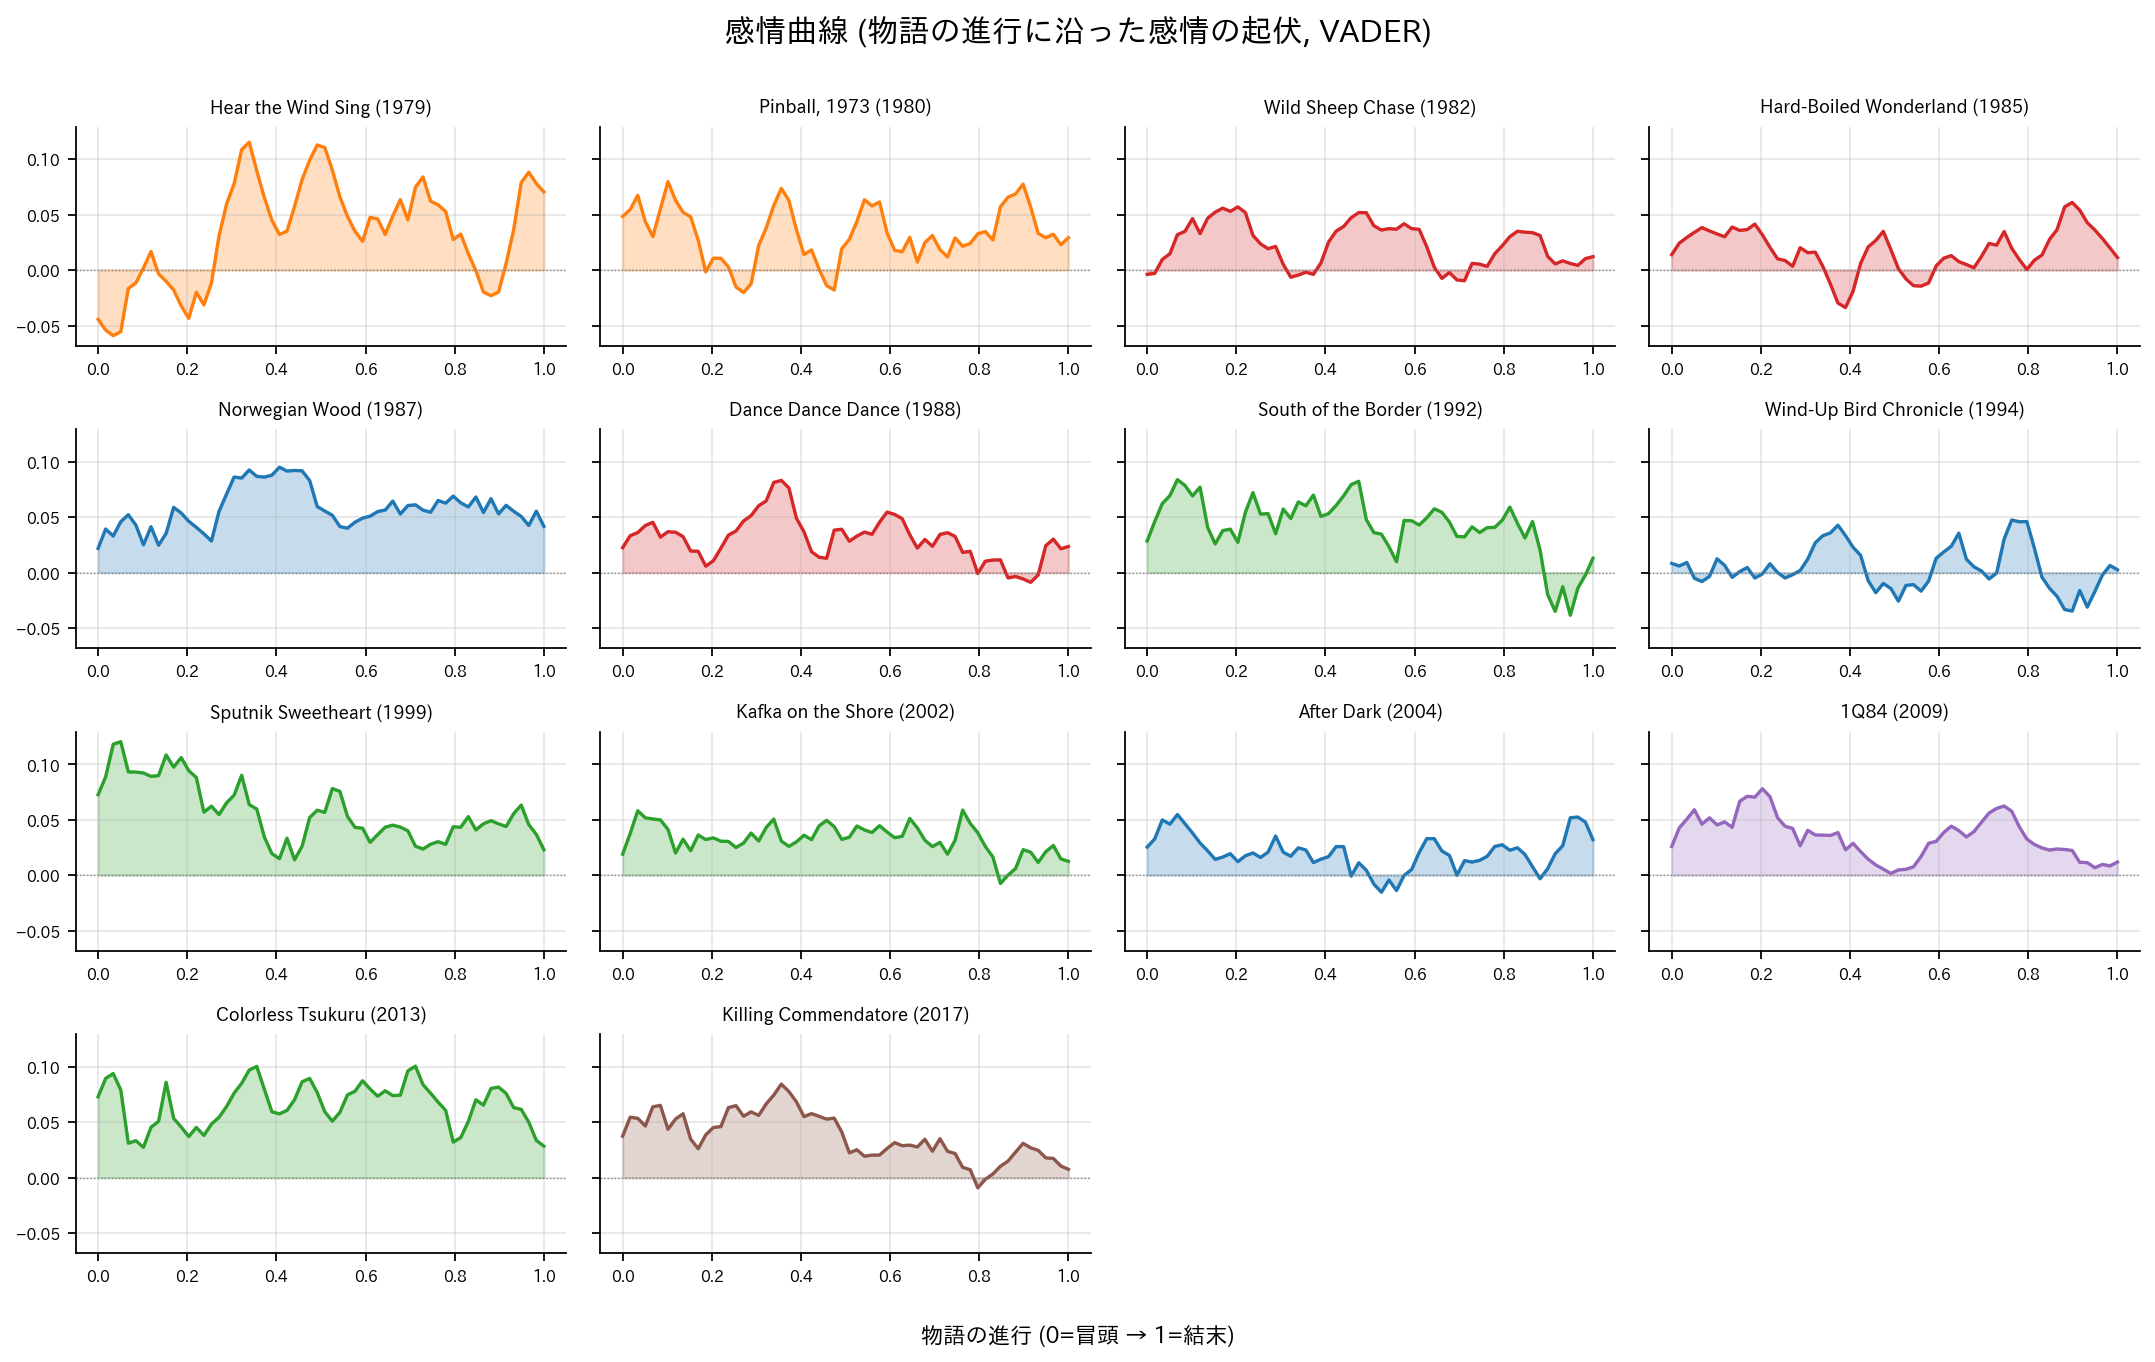
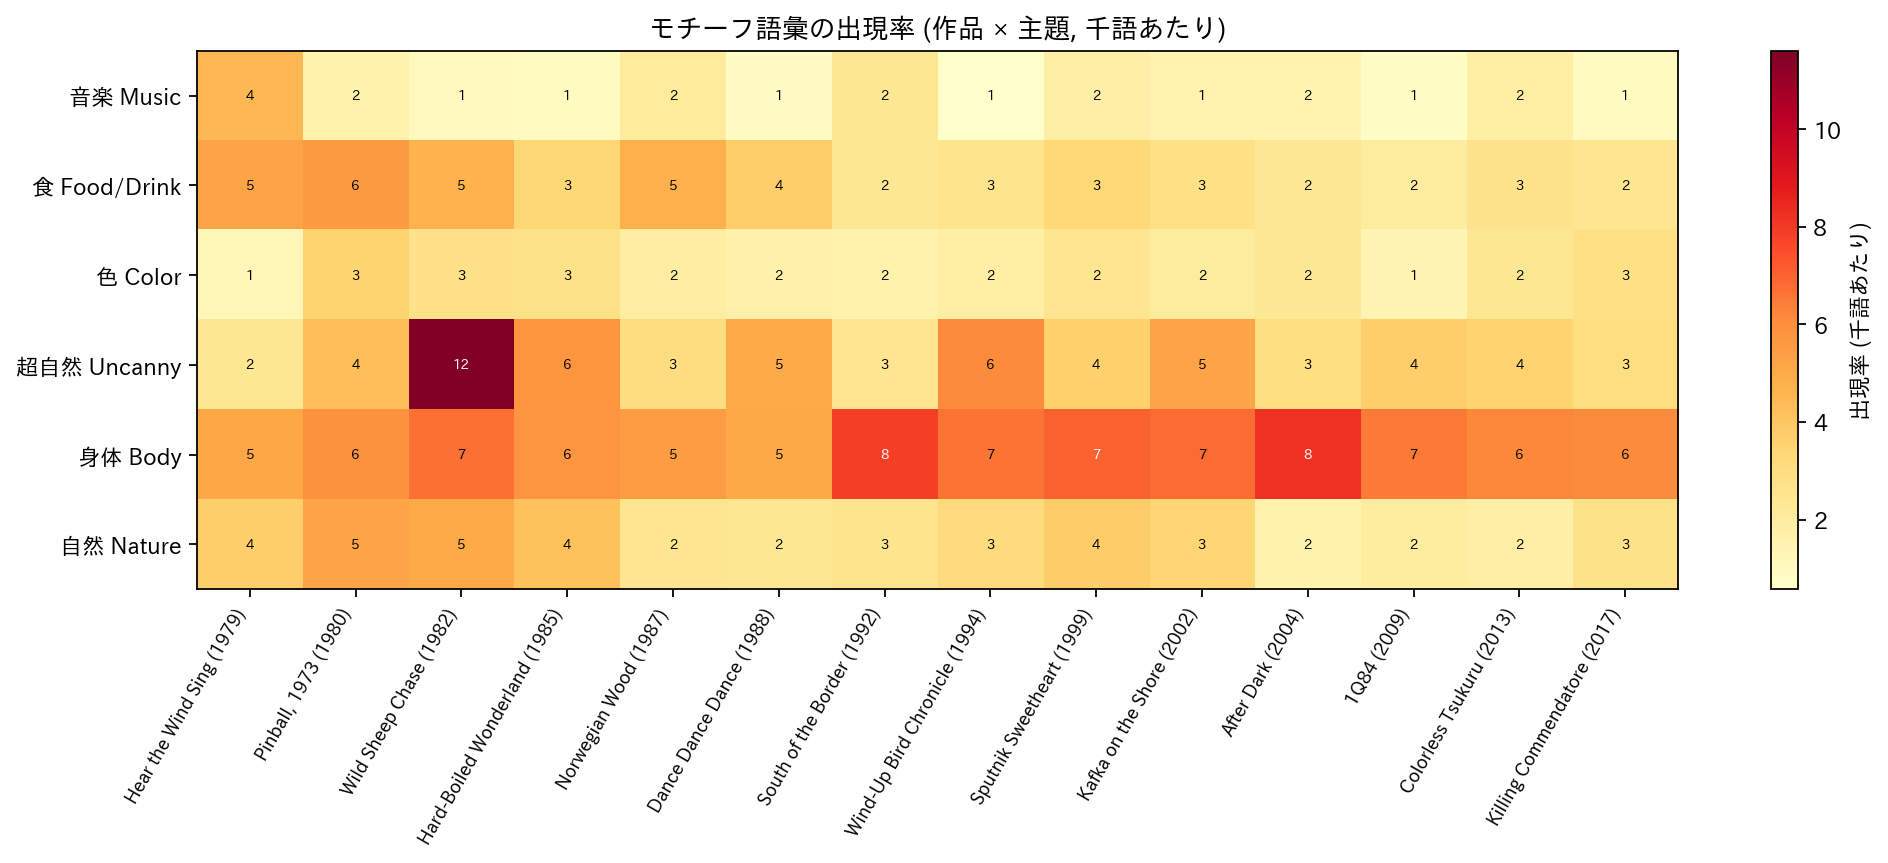
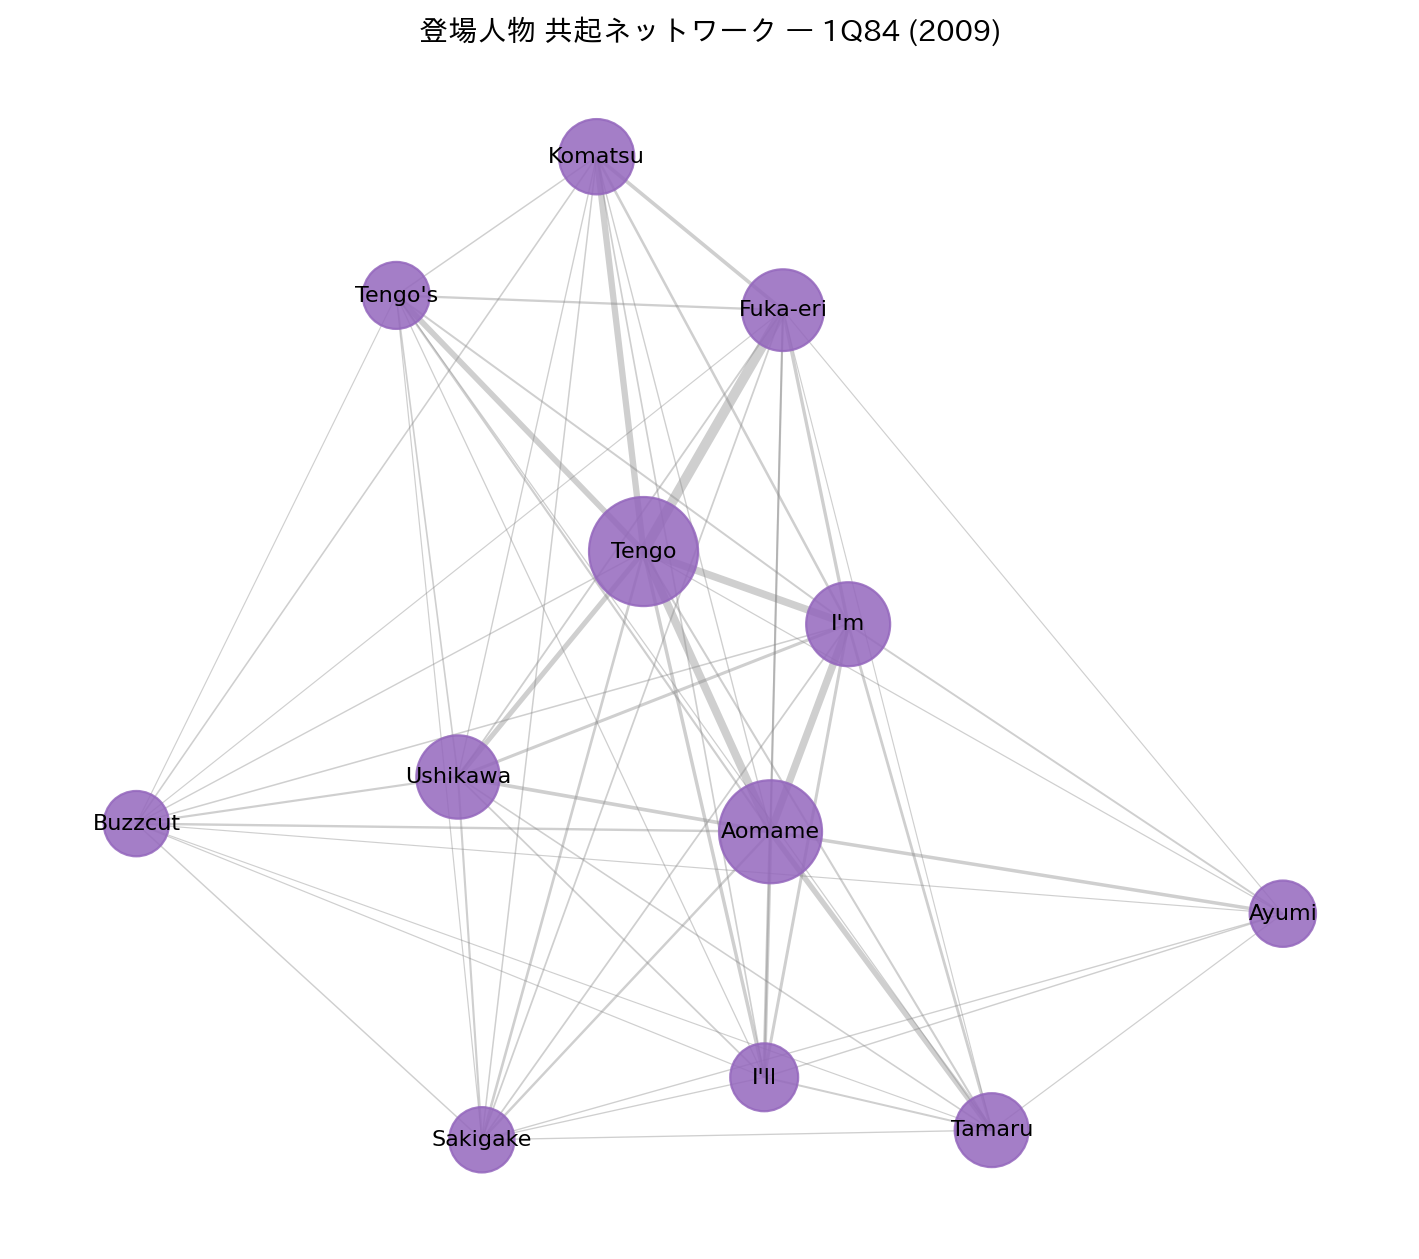
感情辞書(VADER)で物語の進行に沿った感情の起伏を描くと、作品ごとに固有の「形」が見えます。モチーフ語彙(音楽・食・色・超自然・身体・自然)の密度比較では、身体イメージが全作品で高密度に流れることや、『羊をめぐる冒険』で超自然語彙が突出することが分かります。登場人物ネットワークでは、『1Q84』の Tengo と Aomame が二大ハブをなす二重主人公構造が再現されました。
📖 図の読み方
感情曲線(左)は横軸が物語の進行(左=冒頭→右=結末)、縦軸が感情の強さ。0より上が肯定的・下が否定的で、上下動が物語の「感情の起伏(形)」です。モチーフ・ヒートマップ(中)は縦が主題語彙・横が作品で、色が濃いほどその作品でその主題語が密に出ること(千語あたりの出現率)を示します。ネットワーク(右)は点=登場人物、線=同じ場面での共起。点が大きい・線が太いほど中心的で結びつきが強く、図の中心に来る人物が物語の軸だと読めます。
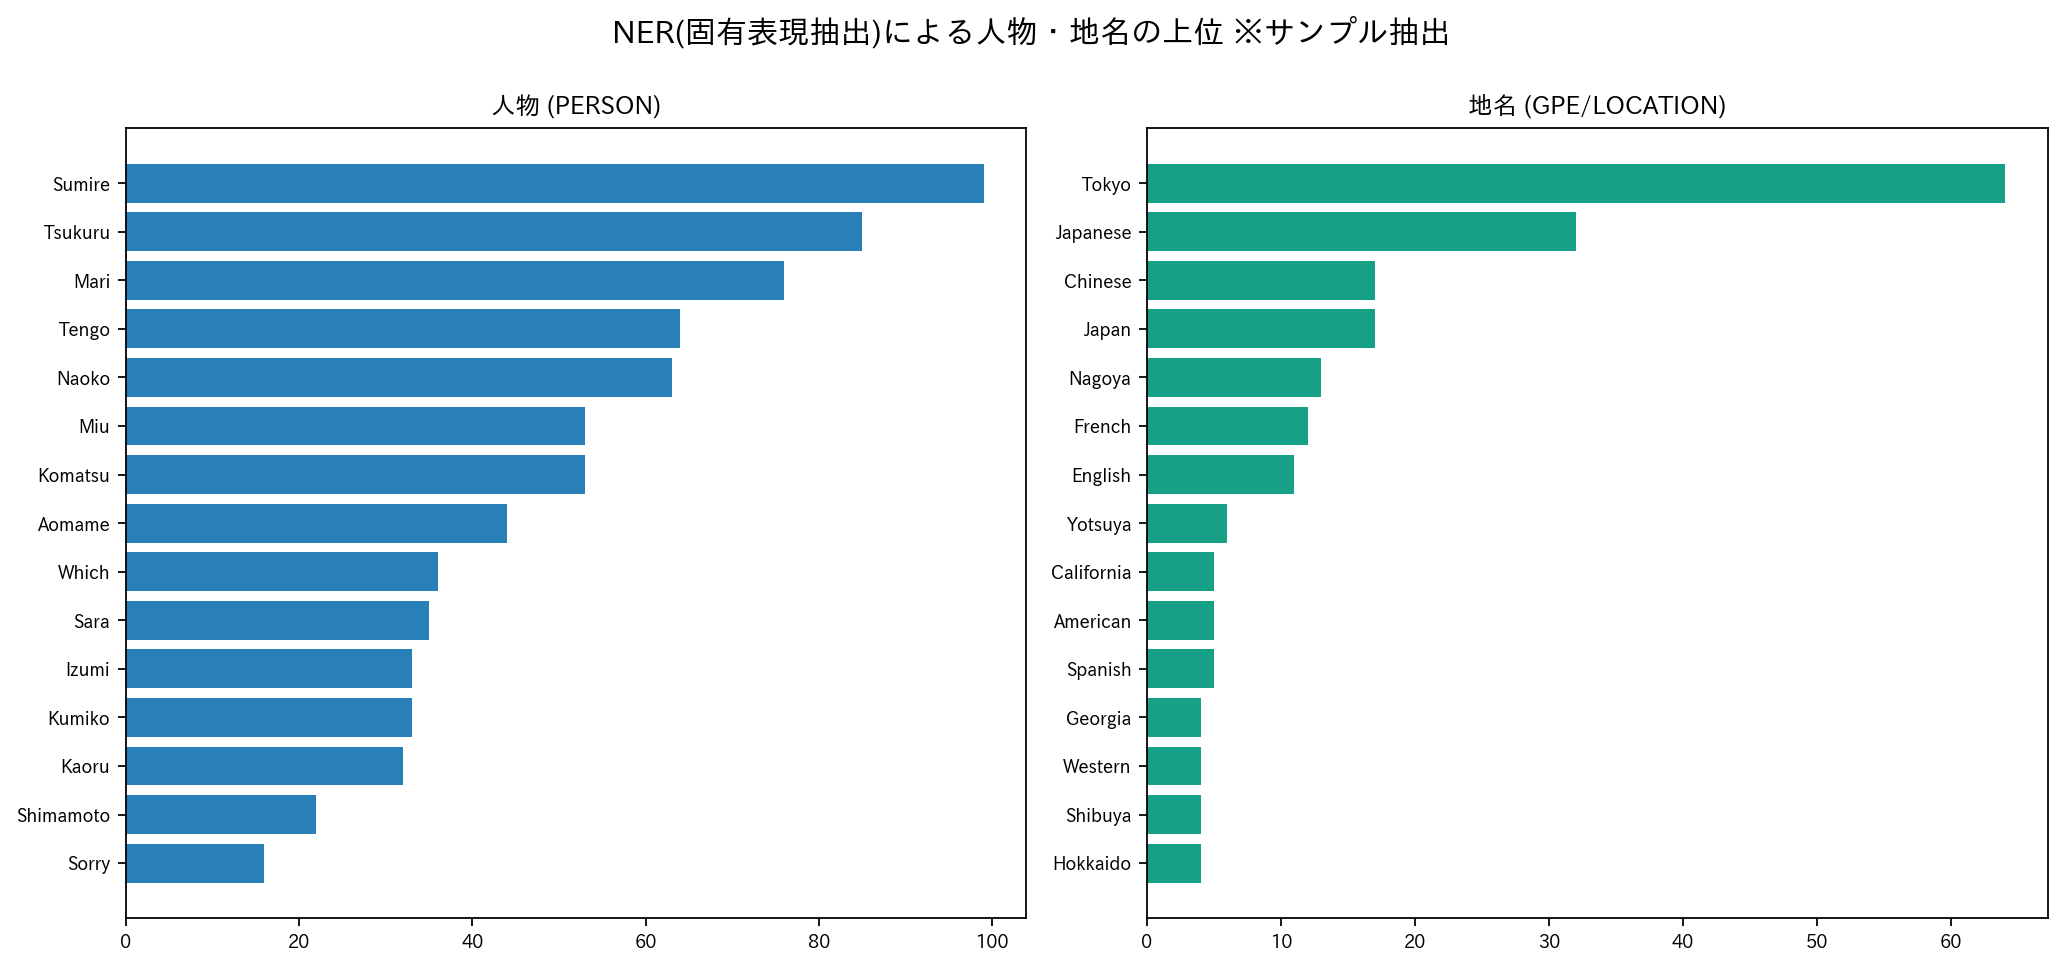
先の人物ネットワークは大文字率による簡易抽出でしたが、本来の固有表現抽出(NER)を用いると、人物(Sumire・Tsukuru・Tengo・Naoko…)と地名(Tokyo・Nagoya・Yotsuya…)を品詞・文脈から同定できます。村上作品の舞台が東京を中心とする具体的な地理に根ざしていることも確認できます。
⑤ 応用:作品内での翻訳者交代を検出する
📖 図の読み方
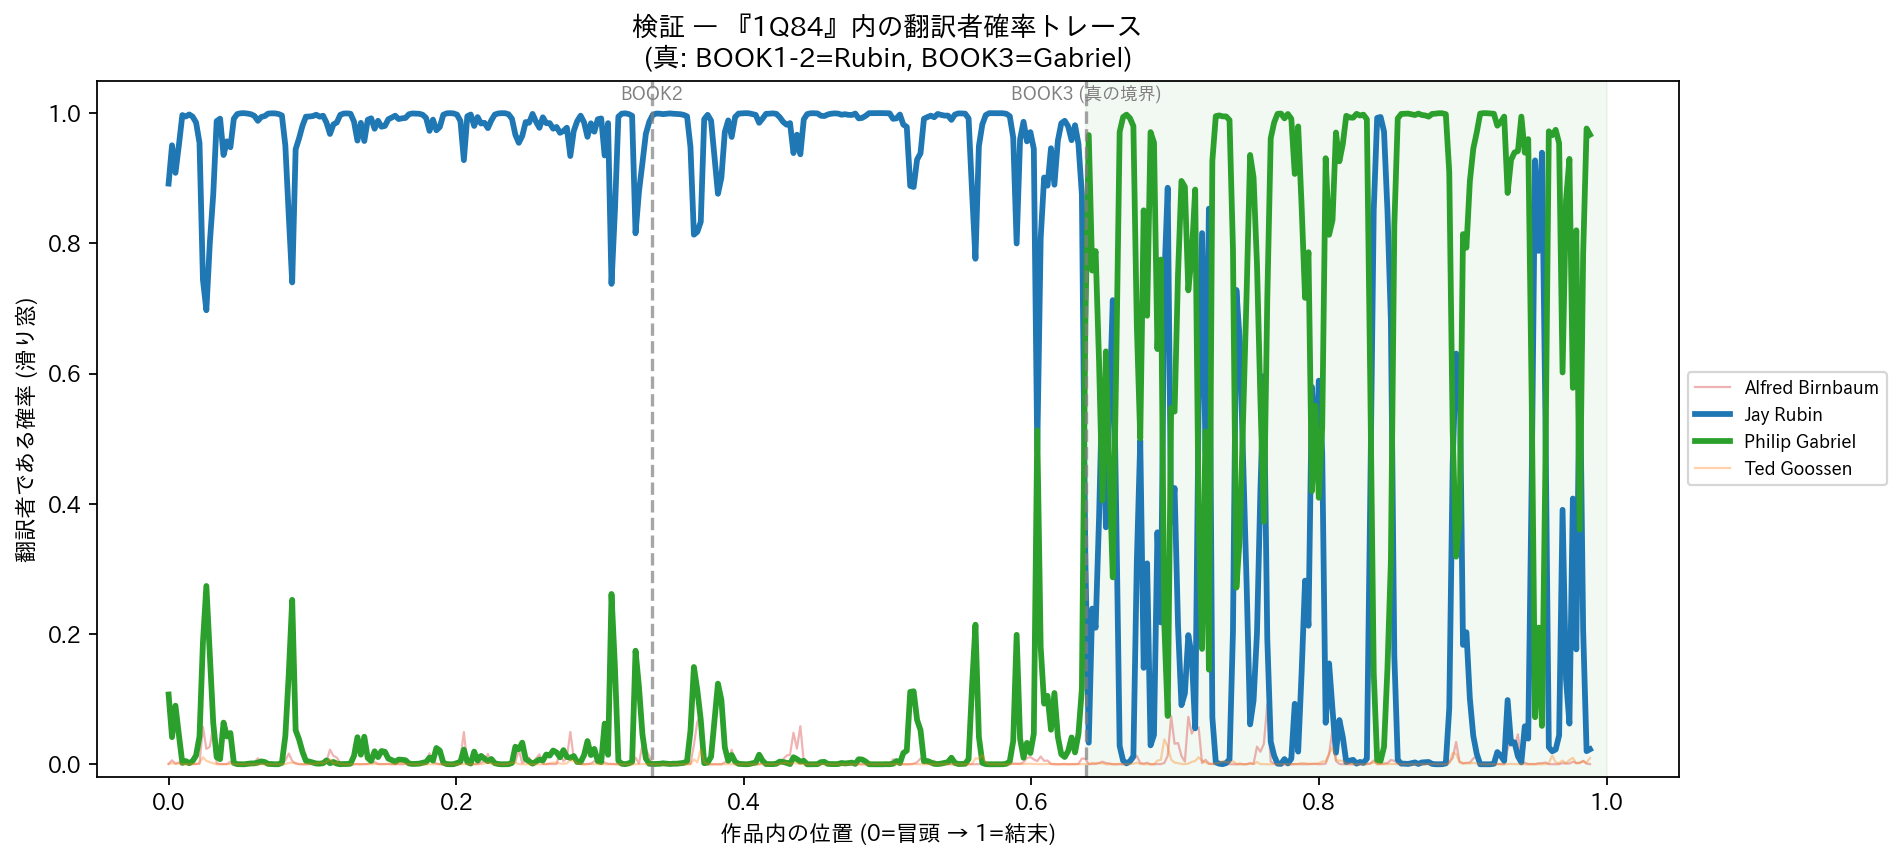
横軸は作品内の位置(左=冒頭、右=結末)、縦軸は各翻訳者である確率。色つきの線が位置ごとに上下し、ある翻訳者の線が高い区間は「そこはその翻訳者らしい」ことを表します。点線が真の境界(BOOK 3)で、そこで青(Rubin)から緑(Gabriel)へ主役の線が入れ替わるのが読み取れます。
『1Q84』は BOOK 1-2 を Rubin、BOOK 3 を Gabriel が訳した混成訳です。訓練した分類器を本文に沿って滑らせると、真の翻訳者交代点(BOOK 3)で確率がくっきり反転しました(P(Rubin) 0.97 → 0.23)。1作品の内部でも翻訳者の交代を文体から検出できる、という強力な実証です。
同じ手法を、Gabriel と Goossen の章分担が公開されていない『騎士団長殺し』にも適用しました。全体の平均確率は P(Gabriel)=0.54・P(Rubin)=0.36・P(Goossen)=0.05・P(Birnbaum)=0.04 で、本作はおおむね Gabriel 寄りの文体を示し、後半にかけて他の翻訳者的な信号が断続的に強まる傾向が見えます。ただしこれは探索的な推定にとどめるべきです ── Goossen は学習データが初期2作のみで指紋が弱く過小検出されやすいこと、Gabriel と Rubin は近年の長編で文体が近く混同しうることに注意が必要です。確定的な結論ではなく、『1Q84』での検証成功が「この手法が原理的に作品内の翻訳者交代を捉えうる」ことを示している、と理解してください。
⑥ 作家としての変遷(1979 → 2017)
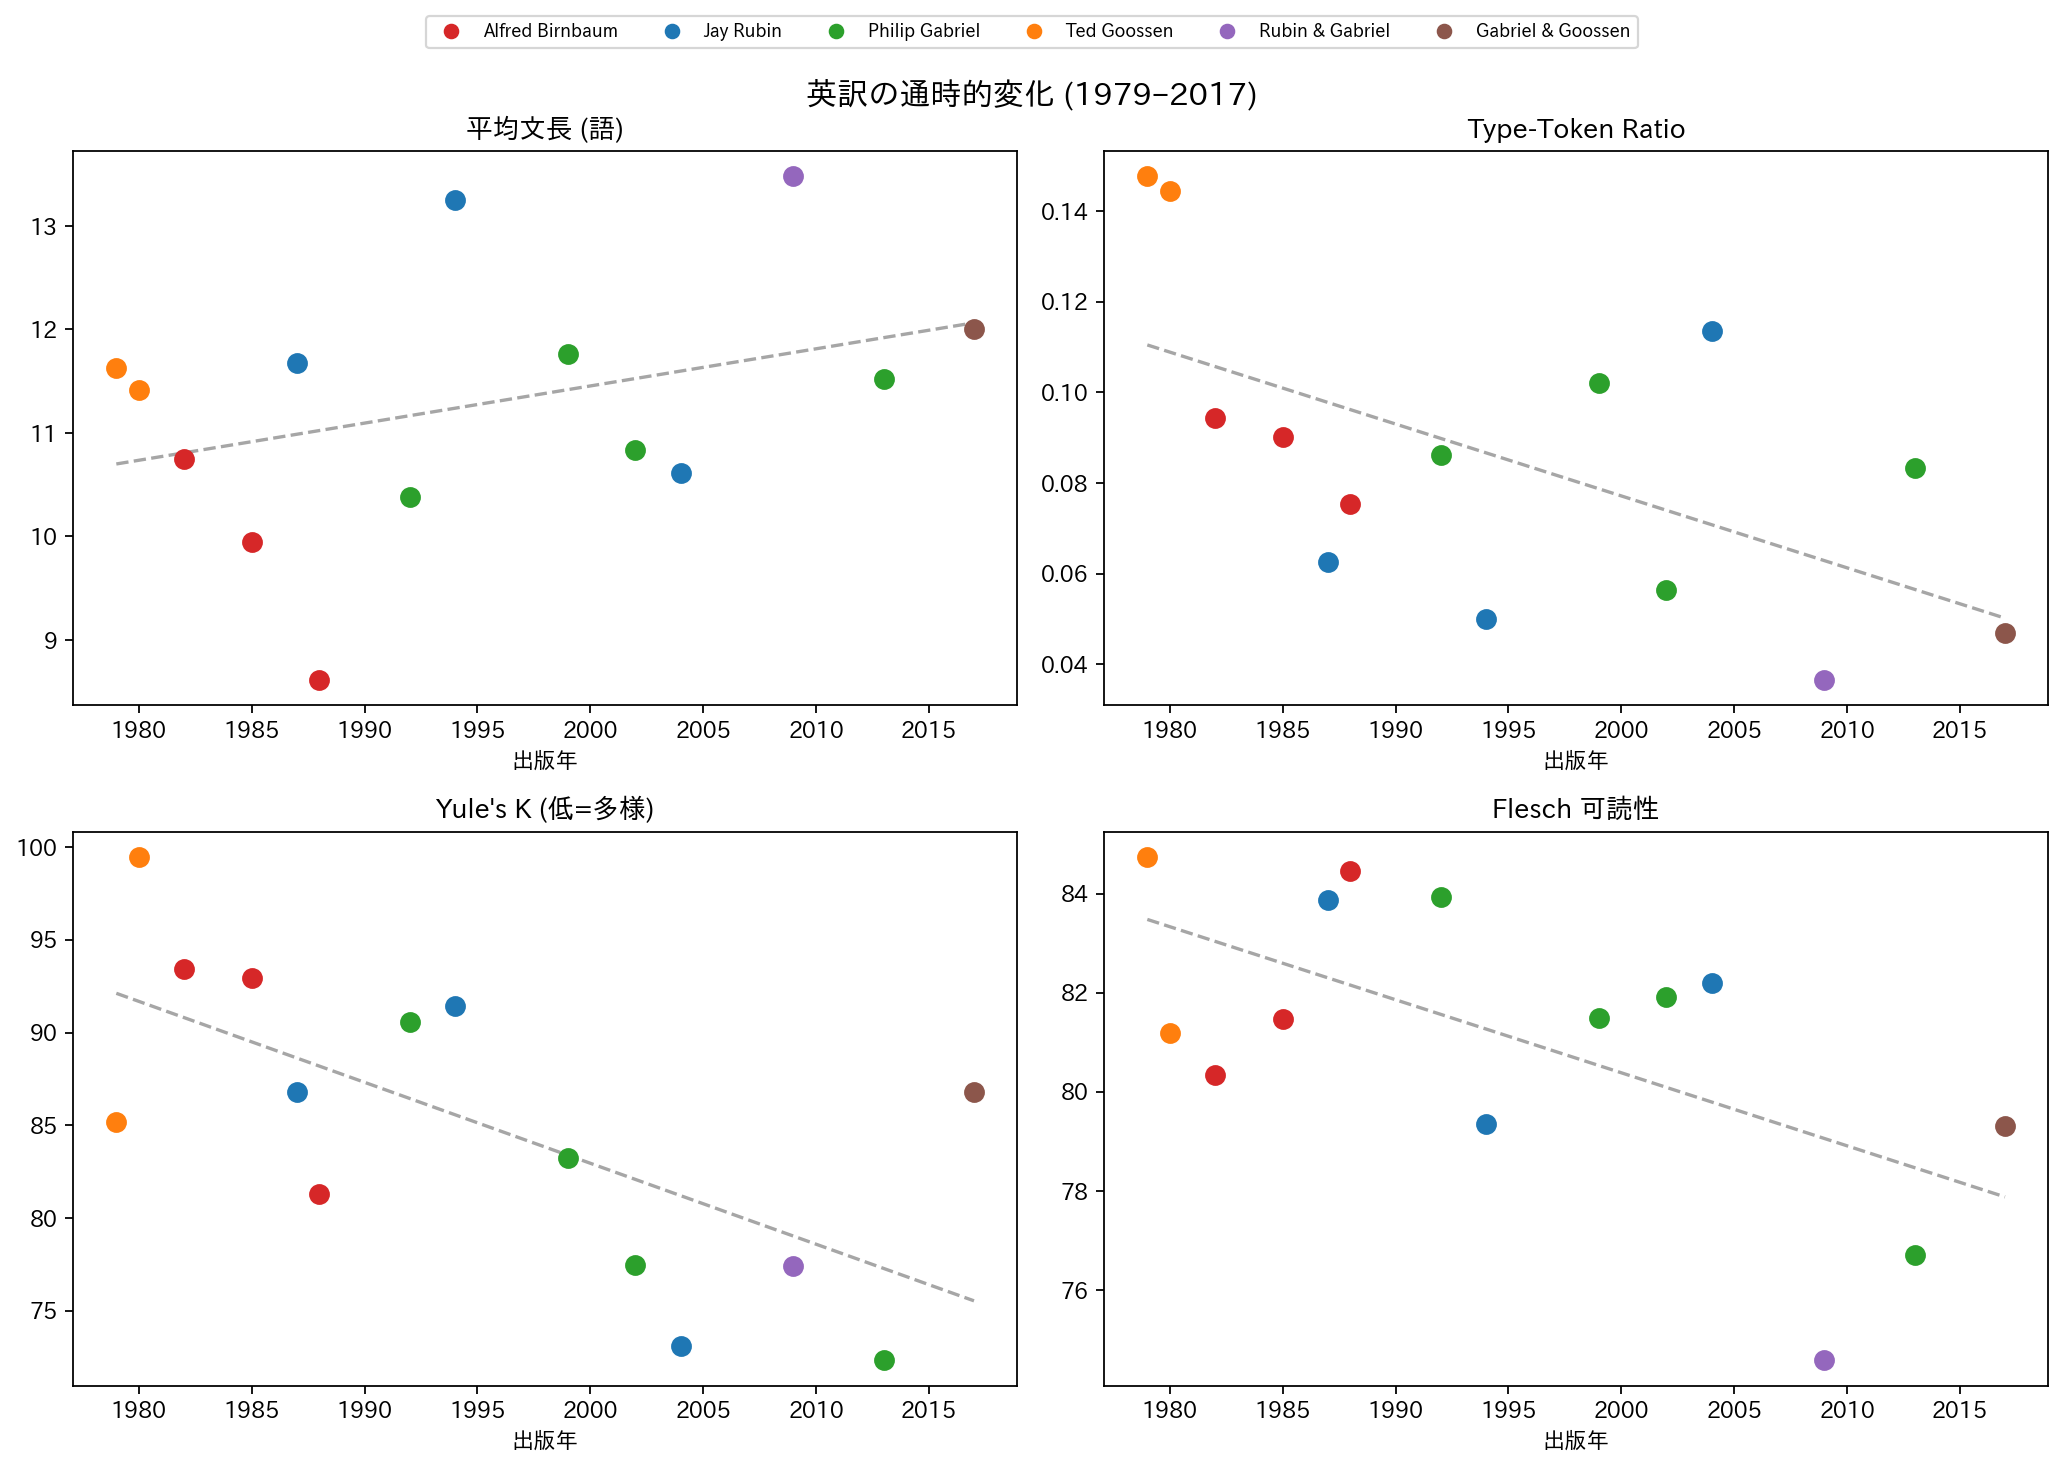
📖 図の読み方
横軸=出版年、各点=作品(色=翻訳者)、点線=全体の傾向線。線が右肩上がりなら、その指標は年とともに増える傾向にあると読みます。
遠読は通時的な変化も捉えます。約40年の間に平均文長はゆるやかに伸び、後期の大長編(『ねじまき鳥クロニクル』『1Q84』)で最大(約13語)になります。
とりわけ興味深いのが語りの人称の変化です。一人称代名詞(I/me/my…)の密度は、僕語りの初期〜中期作で高く(『ノルウェイの森』約70・『国境の南』約80/千語)、三人称で書かれた後期作で大きく下がります(『1Q84』約20・『色彩を持たない多崎つくる』約24)。一方、再び一人称(画家の僕)で語られる『騎士団長殺し』では約56へ戻ります。村上が「僕」の一人称から三人称の語りへ移り、また一人称へ戻るという語りの構えの変遷が、英訳の代名詞頻度にもはっきり刻まれている、と読めます。原作者由来の変化を、翻訳が忠実に伝えている例です。
⑦ 作品論・作家論 ── 遠読が照らす村上春樹文学の読み
ここまでの数値は、それ自体が結論ではありません。遠読の意義は、こうしたパターンを手がかりに作品の読み(解釈)を更新することにあります。本事例の発見を、村上春樹文学そのものの解釈へとつなげてみましょう。これは「数値から読みへ」、すなわち遠読を精読の出発点として使う実践です。
(1) 「僕」から三人称へ ── デタッチメントからコミットメントへ
⑥で見た一人称代名詞の減少は、単なる文法統計ではなく、村上春樹の作家的変貌の指標として読めます。初期の「鼠三部作」や『ノルウェイの森』は、世界と距離を取る受動的な「僕」の語り(デタッチメント)に貫かれていました。しかし『ねじまき鳥クロニクル』以降、語りは三人称へと広がり、BERTopic が抽出した「戦争(ノモンハン)」のトピックが示すように、村上は歴史と暴力へ踏み込みます(コミットメント)。一人称の後退と歴史トピックの登場が同じ時期に重なることは、評論家がしばしば語る村上の「デタッチメントからコミットメントへ」の転回を、テキストの表面から裏づけます。『騎士団長殺し』で再び一人称(画家の僕)へ戻るのは、初期の親密さと後期の構築性を統合しようとする晩年の試みとも読めます。
(2) 井戸・猫・羊 ── 日常に接ぎ木された異界
モチーフ・ヒートマップでは、身体語彙がすべての作品に高密度で流れる一方、『羊をめぐる冒険』で超自然語彙が突出していました。これは村上文学の核心的な手つきを映します。コーヒーを淹れ、パスタを茹で、レコードを聴くといった精緻な日常描写(身体・感覚の語彙)を土台に、その裂け目から「羊」「井戸」「猫」「月」といった異界が立ち上がる。リアリズムと幻想が地続きであることこそが彼の「マジック・リアリズム」の特質であり、数値はその配合比を可視化しているのです。
(3) 二つの世界・二人の主人公 ── 探索の物語の幾何学
『1Q84』の人物ネットワークが Tengo と Aomame の二重ハブを描いたように、村上の長編はしばしば二項構造を取ります。『世界の終りとハードボイルド・ワンダーランド』の二つの世界(TF-IDF が拾った unicorn / skull / shadow =「世界の終り」の街と、影の切断)、『海辺のカフカ』のカフカ少年とナカタさんの交互する語り。意味地図(UMAP)で各作品が島状に分かれて見えるのも、長編がそれぞれ独自の閉じた世界を構築していることの反映です。離れた二つの存在が引き合い、やがて出会う ── これが村上の物語の幾何学だと言えます。
(4) 個々の作品が見せる表情
- 『ねじまき鳥クロニクル』:戦争トピックと井戸のモチーフ、感情曲線の落ち込みが、歴史の暴力への「下降」という主題を映す。
- 『1Q84』:二重主人公と「月」「リトル・ピープル」、宗教団体(さきがけ)── 多声的な世界を志向する後期村上の総合小説的野心。
- 『騎士団長殺し』:painting / portrait / pit(穴)が示す、芸術と「イデア/メタファー」をめぐる物語であり、一人称への回帰でもある。
- 『ノルウェイの森』:超自然語彙が相対的に低く、感情曲線も独特 ── 喪失と記憶を描く異色のリアリズム長編であることが、数値の上でも「外れ値」として浮かび上がる。
いずれの読みも、遠読が問いと出発点を与え、精読がそれを裏づけ深める、という関係にあります(12.1.4 の「中間距離の読解」)。数値はテキストへ立ち返るための道標なのです。
結論 ── 結局、何がわかったのか
本事例の遠読から、大きく次の6点が言えます。
- 翻訳者には「文体の指紋」が実在する。 作品の内容を伏せても、機能語の使い方だけで翻訳者を作品単位 約93%・統計的に有意(p = 0.005)に言い当てられた。指紋は語彙(綴り・機能語)と構文(節・従属)の両面から一貫して確認できた。
- その指紋の中身も具体化できた。 Rubin=フォーマルで複雑、Gabriel=口語的、Birnbaum=簡潔。同一原作(村上)の訳である以上、この差の相当部分は「翻訳者の選択」に由来する。
- 作品内の翻訳者交代まで検出できる。 『1Q84』の BOOK 3 における Rubin → Gabriel の切替を、文体だけから正しく捉えた。
- 翻訳は原作者の変遷も忠実に伝える。 一人称 → 三人称 → 一人称という村上の語りの変化や、戦争・歴史への主題的転回(コミットメント)が、英訳のデータにもはっきり刻まれていた。
- だから「翻訳の特徴」は二層からなる。 作家(原作)由来の一貫した主題・モチーフ・構造と、翻訳者由来の文体差が、同じテキストの上に共存している ── これが本事例の最大の結論である。
- そして遠読は精読の出発点である。 数値は答えではなく問いを生み、テキストへ立ち返るための道標になる。
この事例から学べること
- 前処理が命:作品ごとに異なる OCR ノイズを、固有名詞を壊さず洗浄して初めて分析が成立する。
- 手法は重ねて使う:頻度分析 → 埋め込み → トピック → 文体計量 → 機械学習 → 統計検定、と層を重ねることで主張が頑健になる。
- 遠読は精読に橋を架ける:「Rubin はフォーマル/Birnbaum は簡潔」という量的発見は、実際の訳文を読み比べる精読(close reading)への入り口になる(12.1.4 の「中間距離の読解」)。
- 解釈は人間の仕事:分類器は93%当てるが、「なぜ当たるのか=何が翻訳者らしさか」を意味づけるのは人文学者の判断。
限界と注意点(遠読を過信しないために)
- OCR残渣:洗浄後もごく一部に誤りが残り、特に固有名詞で起こりやすい。
- 交絡:観察された差は「翻訳者」「時代」「原作の性質」が絡み合った合成信号。翻訳者ごとに担当作の主題も違うため、純粋な文体効果の切り分けには注意が要る(だからこそ機能語・構文に注目し、交差検証で内容を統制した)。
- 原文との対照が無い:日本語原文を持たないため、ある差が「翻訳者の選択」か「原作の差」かを最終的に確定はできない。
- 混成訳の推定は探索的:『騎士団長殺し』の分担推定は確定ではない(特に Goossen の学習データ不足)。
- 解釈は人間の仕事:数値は問いの入口にすぎず、結論は精読と文脈知で確かめる必要がある。