内容
視覚資料(画像)を研究対象にする意義
人文学の研究において、文字資料(テキスト)だけでなく視覚資料(画像)を対象とすることには大きな意義があります。文章による記録には限界があり、伝えきれない情報や文脈がありますが、それを補完する手段として画像による視覚情報が必要となる場面も少なくありません。
デジタル技術の進展により、膨大な視覚資料がオンラインで利用可能になりつつあります。図書館や美術館の所蔵品の高精細デジタル画像が公開され、文化資料を「大量」に分析する試みも始まっています。従来、人文学におけるデータ分析はテキスト中心でしたが(いわゆる「ディスタント・リーディング」など)、近年では大規模な画像コーパスを計算機で解析する「ディスタント・ビューイング(distant viewing)」という手法論も提唱されています。
総じて、視覚資料を研究資源にする意義は大きく二つあります。一つは、テキスト資料の記述を補完し、より立体的で実証的な議論を可能にすることです。もう一つは、美術作品や写真・映像といった視覚文化そのものを分析対象に含め、人文学の射程を広げることです。
ディスタント・ビューイング
🐑 はじめに:コンピュータは写真を「見られる」のか?
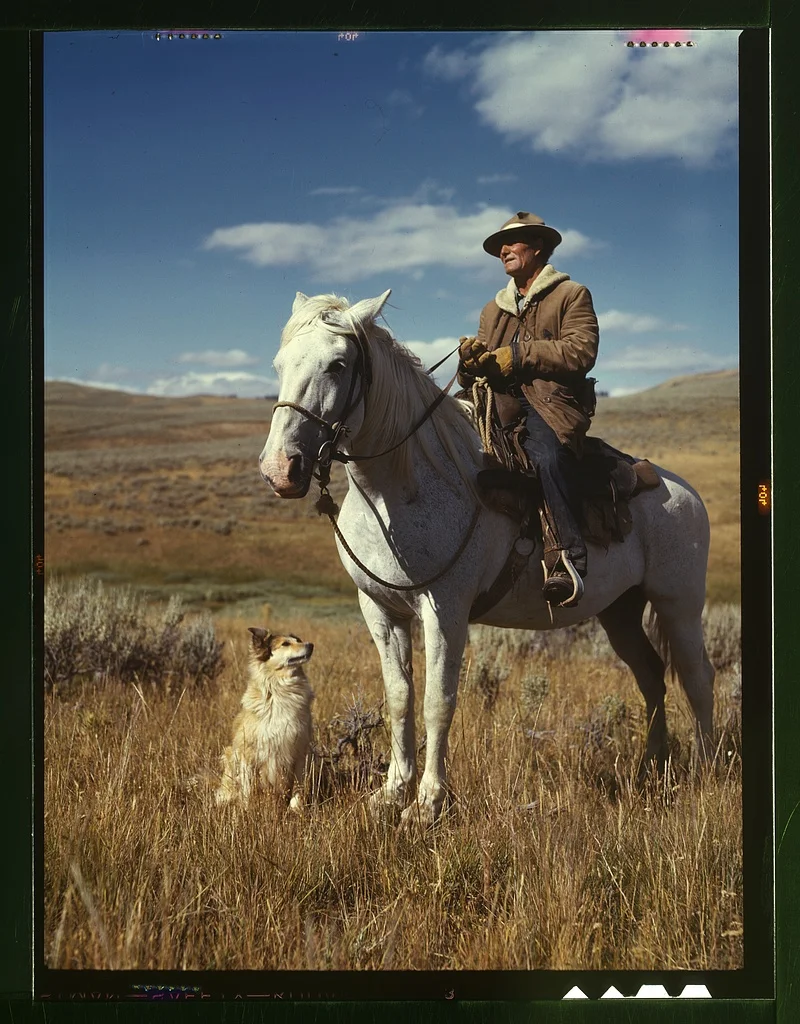
1枚の古い写真があります(右)。モンタナ州の高原で、羊飼いが馬にまたがり、足もとに犬がいる──Russell Lee が1942年に撮ったカラー写真です。人間なら一瞬で「人・馬・犬」と分かります。ところが Arnold と Tilton が最新のコンピュータビジョン(AIの画像認識)にこの写真を見せると、奇妙なことが起こりました。あるモデルは犬のいる場所に「猫がいる」と判定し、しかもその「猫」の確信度81%が、正しい「犬」の59%より高かったのです。別のモデルも犬を猫と取り違えました。
この小さな失敗は、本章の出発点になる大きな問いを投げかけます。計算機は画像をどう「見て」いるのか? その「見方」をどこまで信じてよいのか? 大量の画像をコンピュータビジョンで分析する手法を ディスタント・ビューイング と呼びます。本節では、その考え方・方法・具体例・限界を、Arnold & Tilton『Distant Viewing』(MIT Press, 2023)に沿って見ていきます。
同じ「羊飼い・馬・犬」の写真に対する4種のモデルの出力(Arnold & Tilton 2023, Fig.2.2 より)
YOLO9000
物体を矩形で囲む
人・馬・犬 ◯
Mask R-CNN
領域を塗り分ける
犬を「猫81%」と誤認
COCO Panoptic
空・草・山も分割
やはり犬→猫
DeepPose
人体の姿勢を推定
右脚が写ってない事も検出
現代のカラー写真で訓練したモデルが1941年(原文ママ)の写真をここまで当てるのは驚異的。だが「完全」ではなく、たった1枚にも誤りが潜む。
13.2.1 ディスタント・リーディングからディスタント・ビューイングへ
コンピュータビジョン(Computer Vision)技術を活用して、デジタル化された大量の画像資料を計量的に分析する手法は、近年「ディスタント・ビューイング」(distant viewing)と呼ばれる概念として提唱されています。この用語は、文学研究における Franco Moretti の「ディスタント・リーディング」にならったものであり、大規模なデータを「遠くから」俯瞰することで新たな知見を得ようとするアプローチです。
Arnold と Tilton は 2010年代からこの手法の理論と方法論を発展させており、2023年に著書『Distant Viewing: Computational Exploration of Digital Images』(MIT Press、オープンアクセスで全文公開)を発表しました。同書では、コンピュータビジョンを「視覚的メッセージの研究手法」として用いることの方法論的・認識論的含意を探究しており、画像資料を計算機で分析する際に生じる解釈の問題に焦点を当てています。彼らによれば、人間が画像を見る行為=解釈が不可避であり、画像から意味を抽出する過程自体が解釈的であることを明示的に認識する点にこの手法の特徴があります。
「distant viewing」という語には二重の意味が込められています。一つは目からの距離──計算機は画像を「光の測定値=数値」として計算的に見ます。もう一つはスケールの距離──人が見て記憶できる範囲を超える大量の画像をまとめて扱えることです。そして「viewing(見る)」という語をあえて用いることで、画像分析が文化的・社会的に形づくられた「見る方法(ways of seeing)」に左右される営みであり、コンピュータビジョンは決して中立・客観的ではないことを明示します。
📜 コラム:この理論はどう生まれたか──Photogrammar の物語
ディスタント・ビューイングは、最初から理論として構想されたわけではありません。きっかけは 2010年秋、統計学を専門とする Taylor Arnold と、アメリカ研究・パブリックヒューマニティーズを専門とする Lauren Tilton の出会いでした。二人は Laura Wexler のゼミでの試作から出発し、全米人文学基金(NEH)の助成を得て、FSA-OWI の17万点超の写真を地図や撮影者の足跡から探索できる公開プロジェクト Photogrammar を作り上げます。数百万人が訪れる人気プロジェクトになりました。
ところが「何かが足りない」と二人は感じます。撮影日や場所などのメタデータでは検索できても、肝心の写真そのもの(写っている物や人)で探す手段がなかったのです。当時のコンピュータビジョンは貧弱で、顔検出は帽子をかぶった人を一人も見つけられず、横顔も見逃しがちでした。初期の講演はいつも「アルゴリズムの滑稽な失敗」の紹介で終わっていたといいます。
流れが変わるのは 2016年前後。TensorFlow・Keras・PyTorch・Detectron といったライブラリが登場し、高精度の画像認識が誰でも使えるようになります。この技術的転換と、「では、その新しい"見方"をどう批判的に使うか」という人文学的な問いが結びついて、本書『Distant Viewing』が生まれました。具体的なプロジェクトの「行き詰まり」から理論が育った──研究の現場らしい物語です。
13.2.2 なぜ画像はテキストと違うのか:記号論からの基礎づけ
Arnold と Tilton は、画像がテキストとは異なる仕方で意味を生成することを記号論から説明します。文字は主に慣習によって対象と結びつく記号(シンボル)ですが、画像は線・色・形といった共有された特徴を通じて対象と似る(模倣的・前言語的)。ロラン・バルトは写真を「コードなきメッセージ」と呼び、明示的な符号化なしに意味を伝える特別な地位を与えつつ、画像の意味を デノテーション と コノテーション の二層に分けて考えました。
デノテーション と コノテーション ── 画像の意味の二つの層
デノテーション(明示的意味/外示)
画像が文字どおり何を写しているか。誰が見ても同意しやすい、表面の事実のレベル。「これは何の画像か?」への素朴な答え。
例:海辺に立つ1本のヤシの木、傾いた幹、空の雲。
コノテーション(含意/共示)
そこに文化や文脈が重ねる連想・価値・感情。見る人の知識や立場で変わりうる、解釈のレベル。
例:同じヤシでも「南国の優雅な休暇」とも「嵐の接近する不穏な海辺」とも読める。
同じ1枚でも、デノテーション(写っているもの)は共有されやすい一方、コノテーション(その意味)は文化的に揺れます。バルトは、写真が「コードなきメッセージ」のように直接的に見えても、必ず文化的な含意をまとうことを指摘しました。コンピュータビジョンの注釈は主にデノテーションのレベルを自動化しますが、研究の問いはしばしばコノテーションのレベルにある──ここに人間の解釈が欠かせない理由があります。
メディア理論家 スチュアート・ホール のエンコーディング/デコーディングモデルによれば、画像に込められる意味と受け手が読み取る意味は対称的に一致しません(送り手が意図しなかった意味が読み取られることもある)。同じミーム画像が国によって違って解釈されるのはこのためです。ジョン・バーガー『Ways of Seeing』(1972)は、西洋絵画が女性を「男性のまなざし(male gaze)」のもとに描いてきたことを論じ、「見る/見られる」関係に潜む権力を可視化しました。
こうした違いは実務にも影響します。テキスト分析では解釈を後回しにできます(語の共起を数えてから「天気」の話題と解釈する等)が、画像では計算の前にまず「見て」構造化ラベル(注釈)を作らねばなりません。そしてその注釈づくり自体が、機械を介した一つの「見る行為」なのです。
テキストを「読む」と画像を「見る」はどう違うか
| テキスト(読む) | 画像(見る) | |
|---|---|---|
| 記号の性質 | 慣習で対象と結びつく(シンボル) | 特徴が似て対象とつながる(模倣的・前言語的) |
| 最小単位 | 単語=単独で意味を持つ | ピクセル=文脈に置かれて初めて意味を持つ |
| 圧縮 | 可逆(情報を失えない) | 非可逆でよい(JPEG。近似で十分) |
| 解釈の順番 | 後回しにできる(先に集計→後で解釈) | 先に「見て」注釈を作る必要がある |
本書が繰り返し使う3つの具体例
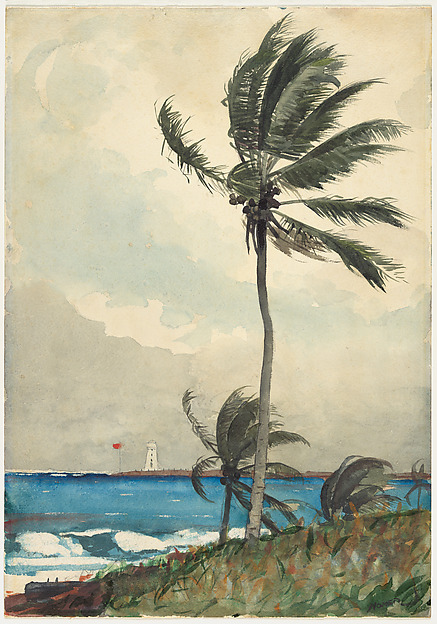
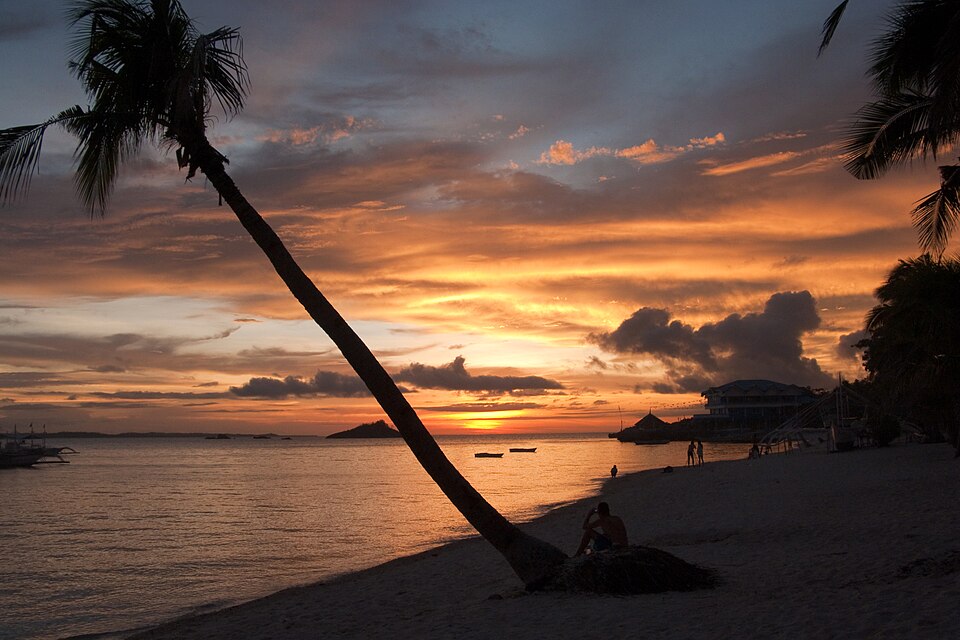
🌴 ヤシの木の2枚
①Winslow Homer『Palm Tree, Nassau』(1898), The MET, CC0/②Vyacheslav Argenberg, CC BY 4.0(参考:海辺のヤシの写真例)
①絵画(水彩)と②写真は、制作も保存形式も正反対で、印字されるピクセルは完全に別物。なのに私たちは両方を「海辺のヤシ」と理解します。さらに②のような画像は、文脈次第で「南国の優雅な休暇」とも、劇的な空から「危険な嵐の接近」とも読める=デノテーション/コノテーションの好例です。
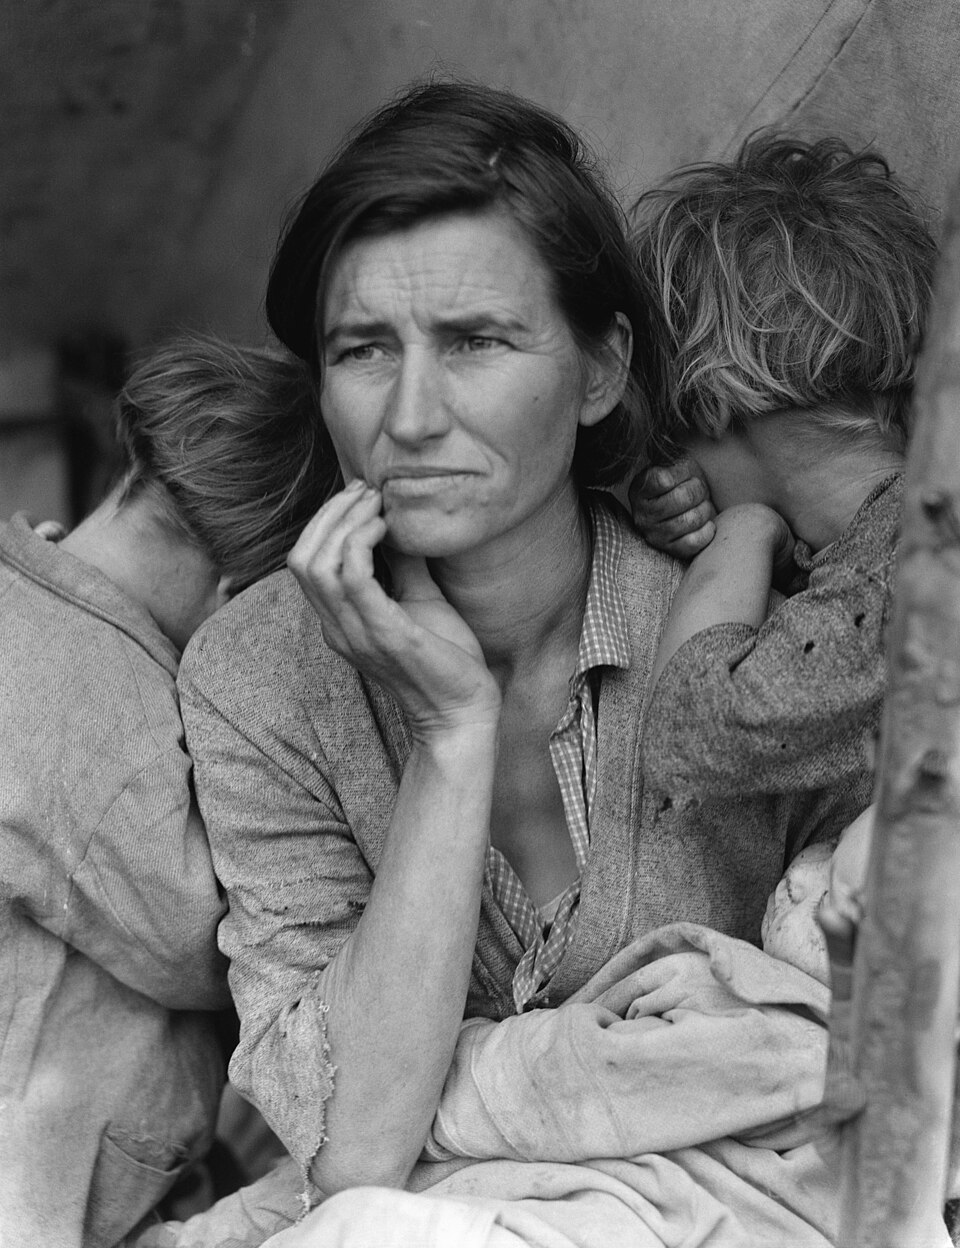
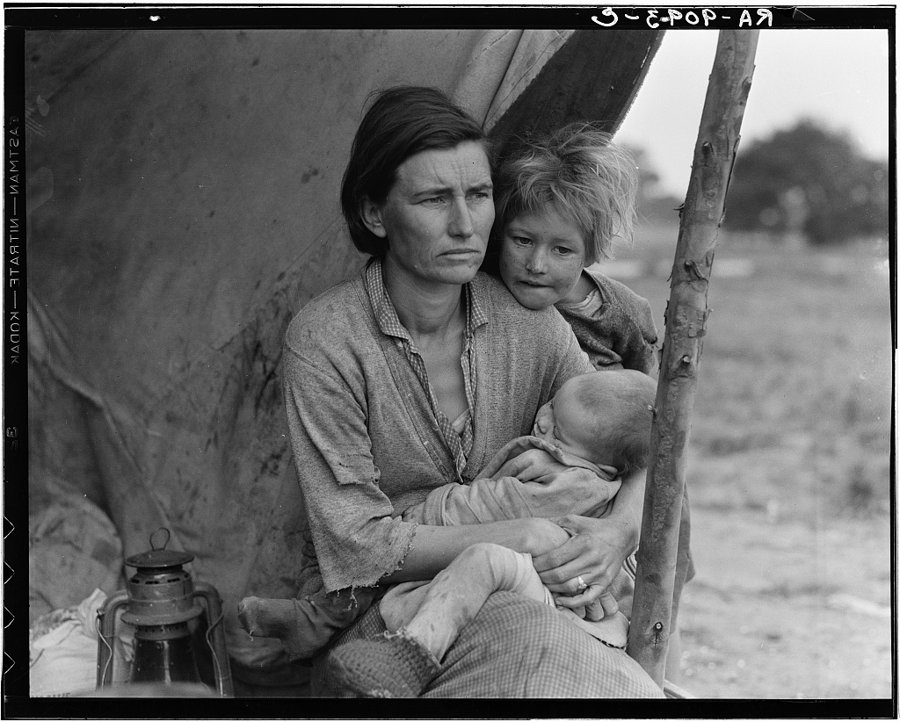
👩👧 移民の母(Migrant Mother)
いずれも Dorothea Lange 撮影, 1936。Library of Congress(パブリックドメイン)
Dorothea Lange が1936年に撮った大恐慌の象徴的な1枚(被写体 Florence Owens Thompson。左図)。だが同じ場面の別アングルの無名の1枚(右図)を並べると、テントや家族の生活が見え、聖母子像的な普遍化が具体的な状況へと修正される。2枚を「会話させる」と新しい文脈が立ち現れる。
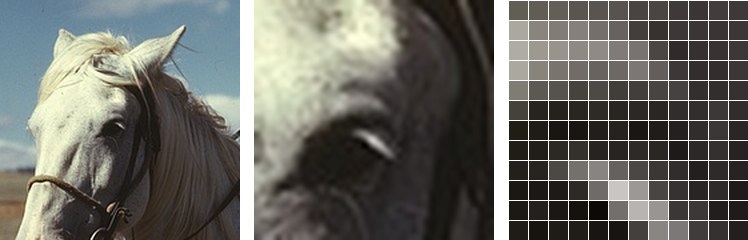
左:馬の顔 → 中:目に接近 → 右:極端な拡大。最後はただの色のマス目になる(元写真:上の羊飼いの写真より作成)
🐴 馬の目をズームすると…
羊飼いの写真の馬の目を拡大していくと、各ピクセルは赤緑青の明るさ(0〜255)の数値にすぎません。いちばん右の色のマス目だけ見せられても「馬の目」とは絶対に当てられない。耳・鼻・たてがみと一緒に置かれて初めて目だと分かる──ピクセルは互いの文脈の中でしか意味を持たない。
13.2.3 対象分野と応用事例の広がり
distant viewing の適用される分野は多岐にわたり、歴史的写真アーカイブ、美術作品の画像データ、映画・映像メディア、広告やポスターなどの視覚資料、さらにはソーシャルメディア上の画像にまで広がっています。
歴史写真アーカイブの分析
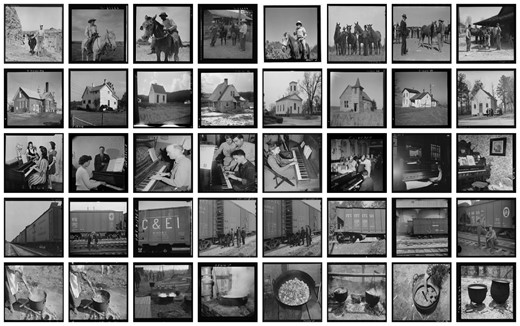
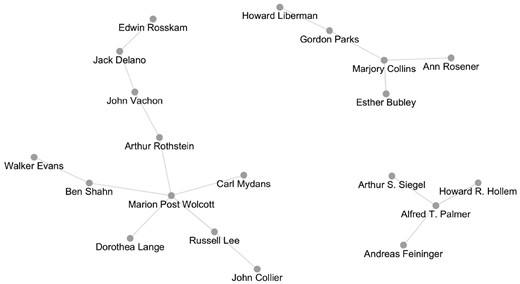
例えば米国の FSA-OWI(農業安定局/戦時情報局)ドキュメンタリー写真コレクション(1935〜43年、約17万点。Dorothea Lange『移民母子』など著名作も含む)に対し、Arnold と Tilton は ImageNet で学習した InceptionV3 モデルの内部レイヤーで各写真を特徴ベクトルに圧縮し、特徴空間上の距離でクラスタリングしました。すると馬・木造家屋・ピアノ・列車の車両・調理用鍋といった「写っている主たる対象」ごとに写真が自動的に集合し、同じ対象なら撮影年・撮影地・写真家が異なってもしばしば近傍に集まりました。さらに上位20名の写真家の視覚的作風の近さをネットワーク化すると、師弟関係にあった Ben Shahn と Walker Evans の近さ、ホームフロントを撮った4名(Siegel・Palmer・Hollem・Feininger)の結束、群衆や公共空間を捉えた女性写真家 Marion Post Wolcott・Marjory Collins が中心的位置を占めることなど、歴史的事実と響き合う関係が浮かび上がりました。
美術作品の数量的な比較
美術史においても、画像データの包括的分析で作品群の傾向を数量的に把握する試みが現れています。K. Bender は「Distant Viewing in Art History」(International Journal for Digital Art History, 2015)で、中世から近代までのアフロディーテ/ヴィーナス図像コレクションから8つのサンプルを抽出し、地域ごとの神話主題の流行の時期差を統計的に比較しました。たとえば英国・アイルランドではヴィーナス神話の人気が18世紀後半にピークを迎え19世紀末まで続いたのに対し、イタリアや低地諸国では19世紀にほとんど描かれなくなるなど、地域間で盛衰に顕著な差が見られました。さらに芸術的生産性が、文献計量学で知られるロトカの法則に従うという規則性も見いだしています。〔発展〕近年では Diana Seave Greenwald『Painting by Numbers』(2021)が仏・英・米の展覧会記録から50万点超の19世紀絵画で主題の盛衰を国別比較し、Peter Bell・Leonardo Impett は「受胎告知」など単一主題の構図変遷を姿勢推定で計量するなど、計算的美術史が広がっています。
映像メディア(動画)への応用
Arnold と Tilton は1960年代のシチュエーション・コメディ2作品『奥さまは魔女』(1964–72)と『かわいい魔女ジニー』(1965–70)の全393話・約150時間・1,300万フレーム超を分析しました。専用に自作したショット境界検出(手動との一致 精度98.7%)でカットを切り出し、Faster R-CNN で顔を検出、VGGFace2 で人物を同定して画面占有時間を計測。すると主要人物の平均登場時間は『奥さまは魔女』のサマンサ7.0分に対し、『ジニー』では男性主人公トニーが11.0分と最大で、表題人物のジニーは3.9分と最少でした。「両作は似た設定だが、前者は対等な夫婦を軸とする家庭劇、後者は男性中心の職場劇」という構造的差異が数量的に示され、「『ジニー』は『奥さまは魔女』の安直な模倣」という通説が反証されました。
映画ポスターの「色」とジャンル
Arnold と Tilton は米国の各年興行収入上位作品の映画ポスター約5,000枚(1970–2020年、IMDb 由来)を HCI(色相・彩度・明度)色空間で分析しました。半世紀でポスターの白の面積は約32%→約5%へ激減し黒が増加(印刷技術の変化)。最も支配的な色相はオレンジ(約54%)ですが、その正体は人物の肌の色でした。「赤=ロマンス」という業界の通説は反証され、むしろ赤はホラー・スリラーと強く結びつきます。さらに暖色/寒色の混在度がジャンルの「シリアスさ」と相関し(ホラーは単一色温度、アニメは混色)、色という単純な特徴でも通説を覆せることを示しました。
ソーシャルメディア画像の分析
近年では、Instagram 等の写真共有プラットフォームに対しても大規模視覚分析が行われています。その一例が Lev Manovich らによる Selfiecity プロジェクト(2014年公開)です。バンコク・ベルリン・モスクワ・ニューヨーク・サンパウロの5都市の Instagram 写真 65万枚超から段階的に選別し、最終的に各都市640枚・計3,200枚の「自撮り(selfie)」を、自動顔解析と Amazon Mechanical Turk による人手評価を組み合わせてデータ化しました。明らかになった傾向としては、自撮り投稿者には女性が男性よりも多いこと(比率は都市差が大きい)、笑顔の度合い(微笑スコア)に都市差があること(バンコク・サンパウロが高くモスクワが最低)、女性は男性よりも頭部を傾ける傾向が強いこと(平均で女性 約12.3度 対 男性 約8.2度=およそ1.5倍)などが挙げられ、文化差・ジェンダー差が浮かび上がりました。
美術館コレクションを「開く」
Arnold と Tilton は、メトロポリタン美術館(MET)が2017年に オープンアクセス(CC0)で公開したパブリックドメイン画像 約24.5万点を題材に、コンピュータビジョンでコレクションを探索しやすくする方法を示しました。物体検出のような特定目的の注釈ではなく、画像埋め込み(InceptionV3 の最終手前層から得る2,048次元ベクトル)で画像どうしの視覚的な類似を測り、UMAP でコレクション全体を一枚の地図に可視化。すると、テキストのメタデータでは結びつかない(例:4つの異なる部門にまたがる似た形の器)作品が視覚的特徴で結ばれ、美術館の部門という分類を横断する新しい発見の経路が開かれました。
🔬 深掘り:背景を測る──FSA写真の「領域分割」(『Distant Viewing』第4章)
物体検出は「人」「車」のような数えられるモノ(things)を見つけます。しかし写真の意味は、しばしば数えられない領域(stuff)──空・地面・草・壁──が担います。Arnold と Tilton は FSA-OWI のうち多作な写真家15人・58,642枚に 領域分割(semantic segmentation)を適用し(ライブラリ Detectron2+データセット MS COCO)、各ピクセルを空・地面・建物・植物などに塗り分けて、それぞれが画像に占める面積の割合を測りました。
面白いのは、同じデータでも「どの粒度でまとめるか」によって見えるものが変わる点です。粗くまとめると政治・時代の構造が、細かくまとめると個々の作家性が、もっと細かくすると既存分類を横断する意外な結びつきが現れます。
同じ写真群、3つの粒度 → 3つの異なる「読み」
粗い:屋外か/人がいるか
2つの○×タグだけで、撮影年・写真家と強く相関。FSA期(土地・農業)→OWI期(工場・製造)という時代の転換が定量的に見える。
中くらい:空・地面・建物・植物の割合
写真家ごとの構図の癖=作家性が出る。Esther Bubley は被写体を見上げ、John Collier は建物を町に溶け込ませる。
細かい:雪・水・ケーキ・自転車…
既存分類を横断する結びつきが生まれる。「水」の写真群は、キャプションが語る産業力とは別の環境批評として再読できる。
さらに、アルゴリズムの「誤り」そのものが史料になる瞬間もあります。物体検出は79種を高い確信度で見つけましたが、「シマウマ」を3件検出しました。コレクションにシマウマはいません──正体は縞模様の囚人服を着た収監者でした。意図せず写り込んだ「監獄国家」の痕跡です。また「バナナ」4枚をたどると、プエルトリコの産地・テキサスの行商トラック・カリフォルニアの協同組合店…と、1930年代の農業サプライチェーンが浮かび上がります。
こうして領域分割は、アーキビスト Paul Vanderbilt が作った既存の主題分類を裏づけ(support)つつ、同時に覆す(supplant)。「全体を数量的に見る」ことと「1枚を深く読む」ことを往復させる、distant viewing の核心がここにあります。
🎬 深掘り:色は嘘をつくか──映画ポスターとジャンル(『Distant Viewing』第3章)
「赤はロマンス、青はアクション」──映画業界にはこうした色の通説があります。Arnold と Tilton はこれを約5,000枚(米国の各年興行上位作品、1970–2020)で検証しました。色を HCI(色相・彩度・明度) で数値化し、ジャンル(IMDb)と突き合わせます。結果、「赤=ロマンス」は誤りで、むしろ赤はホラー・スリラーと結びつきました(血・危険・死の連想)。
ジャンルごとの色の「気分」(第3章の知見を要約)
ホラー / スリラー
黒が支配(ホラーは約53%)。赤が差し色。暗さで恐怖を演出
ドラマ / 伝記
オレンジ=人物の肌が画面の主役。顔のクローズアップ
コメディ / ロマンス
白と明るい色。軽快・幸福・ハッピーエンド
アニメ
最も色彩豊かで鮮やか。現実に縛られない彩度
半世紀でポスターの白は約32%→約5%に激減、黒が増加(印刷技術の進歩)。最頻の支配色オレンジ(約54%)の正体は「人物の肌の色」だった。
決定的だったのは、暖色と寒色の混ざり具合がジャンルの「シリアスさ」と相関したこと。ホラーは単一の色温度で固め、アニメは暖色寒色を混ぜます。これは先行研究にない新発見でした。色という最も単純な特徴量でも、大規模に見れば俗説を覆し、新しい知見を生めるのです。
📺 深掘り:誰が画面の主役か──シットコムのジェンダー(『Distant Viewing』第5章)
動画分析の核心は、フレーム(1秒30枚の静止画)を「ショット」という意味のまとまりに束ねることです。Arnold と Tilton は、魔法の女性が主人公の似た設定の2作品『奥さまは魔女』と『かわいい魔女ジニー』──全393話・1,300万フレーム超──を分析しました。自作のショット検出(手動との一致98.7%)でカットを切り出し、顔検出(Faster R-CNN)と顔認識(VGGFace2)で誰がどれだけ画面に映るかを測ります。
主要人物の平均画面登場時間(1話あたり・分)
表題の女性主人公ジニーは主要人物中で最少。男性のトニーが両作通じて最も長く映る。
『奥さまは魔女』ではサマンサと夫がほぼ対等(7.0/6.9分)の「家庭劇」なのに対し、『ジニー』は男性のトニーが突出する「職場劇」でした。形式的な映像要素だけで、「『ジニー』は『奥さまは魔女』の安直な模倣」という通説が反証され、両作のジェンダーと権力の構造の違いが浮かび上がったのです。
🏛️ 深掘り:収蔵庫を「開く」──美術館とコンピュータビジョン(『Distant Viewing』第6章)
美術館のサイトは普通、テキストの検索ボックス1つでしか探せません。しかし「作者名も主題名も分からないが、こんな雰囲気の作品が見たい」という視覚的な探し方はできません。Arnold と Tilton は、メトロポリタン美術館(MET)が2017年にオープンアクセス(CC0)で公開したパブリックドメイン約24.5万点を題材に、コンピュータビジョンでこの「壁」を越えられるか試みました。
使うのは特定目的の物体検出ではなく、画像埋め込み(InceptionV3 の最終手前層=2,048次元のベクトル)。これで画像どうしの「似ている度合い」を測り、各作品に最も近い15点を結びつけ、さらに UMAP で全体を一枚の地図に広げます。
画像埋め込みがもたらす2つの探索
🔍 近くを見る(推薦)
ある作品から、視覚的に似た作品へたどる。仏の磁器カップ→コプトの鉢→朝鮮の鉢→日本のビーカーのように、館内の4つの異なる部門をまたぐ作品が結ばれる。テキスト検索では各部門が別々の語(saucer/bowl/beaker…)を使うため、決して出会わない接続。
🗺️ 全体を見る(地図)
UMAPでコレクション全体を俯瞰。下に絵画・素描、上に物質文化の写真、といった緩やかな地形が現れ、考古断片の塊なども見える。「美術館の壁(展示)」から「収蔵庫の数十万点」へ探索が広がる。
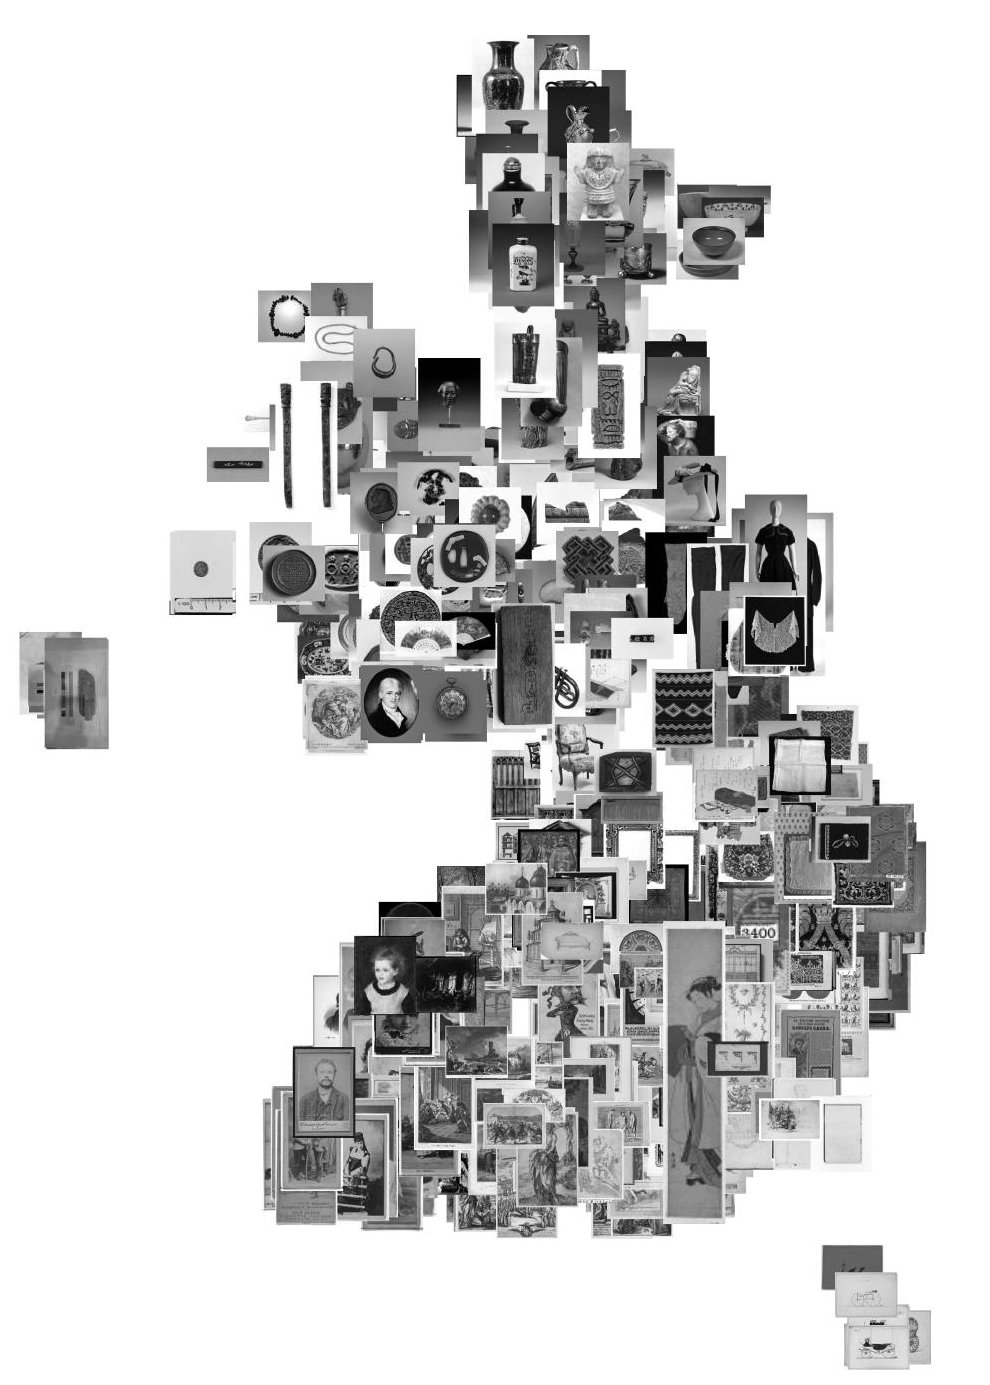
画像類似は、メタデータの誤りや偏りを暴くこともあります。あるドレスが誤って「スーツ(suit)」と記録されていたのを、視覚的特徴が他のドレス群と結びつけて露呈させました。
ただし危険も伴います。自動推薦をそのまま出すと、エジプトのヒヒの小像と人物像、貴婦人の肖像と犬の絵を結びつけ、人間と動物を並置する人種差別的なステレオタイプを再生産しかねません。そこで彼らは、(1)人物を含む画像と含まない画像のリンクを自動削除し、(2)「類似画像」ではなく控えめに「おすすめ(Recommendations)」と呼び、(3)画面上で「アーカイブ由来の情報」と「アルゴリズムが生成した注釈」を太線で明確に区別し、各項目に生成方法の説明を付けました。「明示すること」は万能薬ではないが、設計の誠実さを示す重要な実践です。
13.2.4 ディスタント・ビューイングの方法:4段階のワークフロー
Arnold と Tilton は、データサイエンスの標準的な流れ(編成→探索→伝達)に「注釈」という段階を新たに先頭へ加えることで、画像分析の方法を注釈→編成→探索→伝達の4段階として定式化しました。テキストと違い、画像はまず「見て」構造化ラベルを作らねばならない──この最初の一歩が「注釈」です。
Annotate
CVでラベル生成
Organize
メタデータと結合
Explore
可視化・分析
Communicate
論文・公開UI
①で研究目的に応じ抽出すべき要素を決め(顔の有無、物体カテゴリ、主要な色相など)、コンピュータビジョンで全画像から注釈を生成。②で撮影年や作者などの付帯情報(メタデータ)と結合し、③で統計解析・可視化によりパターンを探索、④で成果を伝えます。ただし一直線ではなく、外れ値が出れば元画像に戻って確かめるなど、各段階を行き来する反復的な過程です。重要なのは、注釈は画像の全情報を捉えるのではなく一部を選び一部を捨てる「破壊的かつ解釈的」な行為だという認識です。
注釈の形はさまざまです──人数などの数値、「肖像」「風景」などのラベル、主要色や物体名の列、内容を述べるキャプション文、さらには「この画像に最も似た画像群」という画像そのもの(画像類似)まで。物体認識は具体的には検出(どんな物体があるか)→位置特定(どこにあるか)→qualification(年齢・向きなど属性)の3段階からなり、YOLO・Mask R-CNN・COCO Panoptic・DeepPose などのモデルが使われます。なお、現代の画像で訓練したモデルは万能ではなく、1941年の写真で犬を「猫(確信度81%)」と誤るような失敗も起こります。
「注釈」とは具体的にどんなものか
この1枚の写真から取り出せる注釈の例(Arnold & Tilton 2023 より)。左ほど客観的、右ほど解釈的になる。
(Russell Lee, 1942, PD)
数えられる・測れる
人数=1/動物=2/顔の高さ=画像の6.6%(64px÷1024px)/顔の座標=(200,250,500,550)
色・明るさ
#503C28(暗いオレンジ=人や馬)#374A66(暗い青=空)平均輝度0.40・平均彩度0.42
カテゴリ(具体的→抽象的)
草・青空・雲(具体的)…… 労働・寒さ・忠誠(抽象的・主観的)
右にいくほど「答え」が文化に左右される。どの注釈を作るかの選択が、すでに一つの「見方=解釈」になっている。
画像分類と物体検出
画像に写っている物体やシーンの種類を自動判別する技術で、深層学習の畳み込みニューラルネットワーク(CNN)モデルによって近年飛躍的に精度が向上しました。FSA 写真の事例では、ImageNet データで学習した汎用物体認識モデル(InceptionV3)の内部表現を利用し、画像ごとの特徴ベクトルを算出しています。
顔検出・顔認識
人物が写った写真や映像では、顔を自動検出して人物ごとに識別・集計することで、その出現頻度や画面占有時間を測定できます。先述のテレビ番組の研究では、オープンソースの顔解析ツールキット(OpenFace)を改変して各ショット中の顔位置を検出し、独自のショット検出アルゴリズムと組み合わせて、クラスタリングによって同一人物を識別する手法が取られました。
画像埋め込みと次元圧縮
物体認識モデルの最終手前の層から得られるベクトル(画像埋め込み。ResNet-50 や InceptionV3 で2,048次元など)は、訓練した分類タスクを超えて色・形・構図・テクスチャを総合的に捉えます。これを使えば、各画像を「最も似た画像群」で表す画像類似が可能になり、主成分分析・t-SNE・UMAP で2次元地図に圧縮すればコレクション全体の分布を俯瞰できます。MET の事例(前述)はまさにこの手法でコレクションを横断的に「開いて」います。
注意点:技術のバイアス
Arnold と Tilton は、既存のコンピュータビジョン技術の多くが軍事や監視目的で開発されてきた経緯や、現代の写真で訓練されたモデルをそのまま歴史資料に適用する際の問題を指摘しています。例えばカラーの現代写真で学習した物体認識モデルを白黒の歴史写真にそのまま適用すると性能が十分でない場合があること、顔認識でも訓練データが偏っていれば特定の人種・性別に対する精度が異なる可能性があることが報告されています。実際、Buolamwini と Gebru の「Gender Shades」(2018)は、商用の性別分類システムで肌の色が濃い女性の誤分類率が最大34.7%に達する一方、肌の色が薄い男性では0.8%にとどまるという大きな精度格差を明らかにしました。
13.2.5 人文学研究における理論的意義と批判的検討
ディスタント・ビューイングの理論的意義は大きく分けて二つあります。第一に、人文学の射程を広げる方法論的挑戦としての意義です。視覚文化研究や美術史・映画研究において、作品一点ごとの詳細な「読む」作業に加え、コーパス全体を巨視的に「見る」ことで初めて見いだせる現象があることを示しました。
第二に、人間による解釈と計算機による分析の協働という点での意義があります。Arnold と Tilton は、画像を計算機で分析する際にも暗黙のうちに解釈が入り込むことを強調し、むしろ人文学の知見を用いて積極的に注釈スキーマを設計することを提唱しました。
同時に彼らは、コンピュータビジョンは「中立な記述装置」ではなく一つの「見る方法」であると繰り返し説きます。何が注釈可能かは、技術の開発を駆動してきた資金や産業・政府の用途に左右されます(顔・車・横断歩道・信号の高精度な検出は、監視や自動運転の応用の産物です)。それゆえ研究者は、アルゴリズムが何を見て、何を誤ってラベル付けし、何を見落とすのか、なぜそう設計されたのかに対して説明責任を負います。実際、MET の事例で画像類似をそのまま使うと、エジプトのヒヒの小像と人物像を結びつけてしまうなど、人種差別的なステレオタイプを再生産しかねない危険があり、彼らは人物を含む画像と含まない画像のリンクを自動削除し、生成方法を画面上で明示するなどの対策を講じました。
そして批判的な検討も欠かせません。Moretti が「全体を数量的に見ることで失われるものはないか」と述べたように、巨視的分析は細部の文脈や作品固有の意味を捨象するリスクがあります。遠隔(distant)と近接(close)のバランスが重要であり、計算機が示したパターンは、実際に作品を見る経験や歴史的・社会的文脈の知識と組み合わせて初めて意味づけられます。
📒 この節のキーワード(ミニ用語集)
ディスタント・ビューイング:コンピュータビジョンで大量のデジタル画像を計算的に分析する手法・理論。文学の「遠読」に由来。
コンピュータビジョン:人間の視覚の働きを模す計算技術の総称。物体検出・顔認識など。本書は「中立な技術」ではなく社会的な「見方」と捉える。
注釈(アノテーション):画像の情報を捉えた構造化ラベル(数値・カテゴリ・キャプション・類似画像など)。一部を選び一部を捨てる「破壊的かつ解釈的」な行為。
ピクセル:デジタル画像の最小要素。赤緑青の明るさ(0〜255)の数値。単独では無意味で、文脈の中でのみ画像になる。
デノテーション/コノテーション:バルトの区別。前者=直接写すもの、後者=文化的に上書きされる含意。
エンコード/デコード:ホールのモデル。送り手の意味と受け手の解釈は一致しない。
物体検出/領域分割:前者は「人・車」など数えられるモノを矩形で、後者は空・地面などの領域をピクセル単位で塗り分ける。
画像埋め込み:ニューラルネットの中間表現で各画像を数値ベクトル化。画像どうしの「類似」を測れる。
UMAP / t-SNE:高次元の特徴ベクトルを2次元に圧縮し、コレクション全体の分布を地図のように可視化する手法。
転移学習:別の課題で訓練済みのモデルを、調整して新しい領域に転用すること。探索的分析の主力。
💭 考えてみよう・やってみよう
- ●同じ1枚の画像を、複数のAI画像認識サービス(例:Google Vision、各種キャプション生成AI)にかけ、出力されるラベルやキャプションの違いを比べてみよう。「何が特権化され、何が見落とされるか」を話し合ってみる。
- ●自分の研究で使いたい注釈(例:絵画の様式、人物の感情、ジェンダー表象)は、「答えの明確な簡単な課題」だろうか、それとも「文化に深く媒介された難しい課題」だろうか。切り分けてみよう。
- ●あなたの扱う画像コレクションを「遠くから(distant)」見ると何が分かり、「近くで(close)」1枚を読むと何が分かるだろうか。両者をどう往復させるか考えてみよう。
📖 原典で深める(オープンアクセス)
本節は Taylor Arnold & Lauren Tilton『Distant Viewing: Computational Exploration of Digital Images』(MIT Press, 2023, CC BY-NC-ND)に基づきます。全文と、データ・コード・対話的な可視化が distantviewing.org/book で公開されています。同書の結語の一句――「さあ、一緒にディスタント・ビューイングを(Let's go distant viewing together)」。
IIIF の仕組み:画像配信とプレゼンテーション
デジタル時代に大量の画像を活用するには、標準化された仕組みが重要です。IIIF(International Image Interoperability Framework)は、まさに画像データの標準化と相互運用を目的とした国際的な枠組みです。
IIIF Image API による画像配信
Image API は、ウェブ上で画像を表示・操作するための統一的な画像取得方法を定めた API 仕様です。画像サーバに対して HTTP リクエストで URL パラメータを指定することで、画像の一部分(領域)や縮小画像、回転画像、白黒画像など、種々のバリエーションの画像データを取得できます。
https://{画像サーバ}/{識別子}/{領域}/{サイズ}/{回転角度}/{画質}.{形式}
例えば /full/full/0/default.jpg は「画像全体をオリジナルサイズで、0度回転、デフォルト画質の JPEG 形式で取得する」ことを意味します。なお、サイズ指定の full は Image API 3.0(2020年)で max に置き換えられたため、3.0 準拠の書き方は /full/max/0/default.jpg となります(領域指定の先頭の full=画像全体は両バージョン共通)。領域やサイズを細かく指定することもでき、例えば /pct:10,10,80,80/500,/0/default.jpg は「左上から縦横10%の位置を起点に幅・高さ80%の領域を切り出し、幅500pxに縮小、0度回転で取得」を意味します。
IIIF Presentation API とマニフェストの構造
Presentation API は、画像を含むデジタルオブジェクトの構造や基本的なメタデータを記述し、ビューワでの表示方法を定めるための API 仕様です。中心概念がマニフェスト(manifest)と呼ばれる JSON-LD 形式のドキュメントで、これが一つのオブジェクト(例えば一冊の書物、一枚の絵画、一冊の写真アルバム等)を記述します。マニフェストには、そのオブジェクトに含まれる画像群の構造(ページ順序や章立てなど)や、基本的な書誌メタデータ(タイトル、作成者、年代、ライセンス情報等)が含まれています。
要約すれば、マニフェストは「あるオブジェクトの基本メタデータ」と「中身の画像群の構造および画像への参照」をひとまとめに記述したものと言えます。この統一形式により、異なる機関の画像資料であってもマニフェストさえ取得すれば共通の方法で扱える利点があります。
IIIF ビューワの活用
IIIF のもう一つの重要要素は、対応するビューワ(viewer)です。代表的な汎用ビューワには Mirador や Universal Viewer、OpenSeadragon などがあります。OpenSeadragon は IIIF 専用ではなく、深ズーム(高解像度のタイル画像をなめらかに拡大)を担う汎用の画像ビューワで、IIIF にも対応し、Mirador や Universal Viewer も内部の画像描画にこれを利用しています。これらを用いると、IIIF マニフェストさえ指定すれば、画像コレクションをページめくり形式で閲覧したり、ズームや回転、明るさ調整、比較表示(複数の画像を並べて比較)などの操作が可能です。特に Mirador は、複数の IIIF マニフェストを同時に読み込み、別々のコレクションからの画像を並べて比較検討するといった高度な使い方もできます。
IIIF を使った画像収集
13.4.1 IIIF 公開 API の事例紹介
国立国会図書館(NDL)
日本の代表的な IIIF 対応データベース。2018年に IIIF 対応を開始し、著作権保護期間が満了してインターネット公開されている資料について IIIF マニフェストが提供されています(対応開始時で約34万点、以後も拡大)。明治・大正期の書籍から浮世絵、古写真まで多様な資料が含まれ、数十万点規模の高精細画像を IIIF 経由で取得できます。
ワーバーグ研究所(Warburg Institute)
イコノグラフィック・データベースも IIIF に対応した重要なリソース。同データベースは主に西洋美術の主題分類にもとづき画像が整理されており、古典神話や歴史、日常生活、宗教寓意などのカテゴリ別に検索・閲覧できます。登録画像数は写真コレクションからの約8万点とその他2万点、計10万点ほどにのぼります。
メトロポリタン美術館(The MET)
オープンアクセス戦略の一環として、所蔵美術品画像の大量公開を行っている代表的な美術館。2017年開始の Open Access プログラムでは、約40万6千点の所蔵品画像が CC0(パブリックドメイン相当)として公開され、誰でも利用可能です。ただし MET の提供は RESTful な Collection API と画像ダウンロードが中心で、フル機能の IIIF マニフェスト対応は他機関ほど整っていない点に注意が必要です。
上記以外にも、ヨーロッパの美術館・図書館には IIIF 対応が急速に広まっています。大英図書館(British Library)、フランス国立図書館(BnF / Gallica)、米国議会図書館(Library of Congress)なども IIIF マニフェストを提供しています。また日本国内でも、国文学研究資料館(国書データベース)の古典籍資料や、東京国立博物館ほか(ColBase)の所蔵品画像などが IIIF で公開されています。
13.4.2 IIIF マニフェストの取得と解読方法
具体的に IIIF から画像を収集するには、まず目当ての資料のマニフェスト URL を取得する必要があります。マニフェストは JSON 形式で提供されているため、ウェブブラウザで直接内容を確認することもできますし、Python などを用いてプログラム的に処理することも可能です。
import requests, json
# マニフェスト URL を取得
url = "https://dl.ndl.go.jp/api/iiif/1234567/manifest.json"
res = requests.get(url)
# マニフェスト JSON を Python の辞書オブジェクトに変換
manifest = res.json()
# タイトルを取得
title = manifest.get("label", "No Title")
# 最初のキャンバスに含まれる画像 ID を取得
canvas0 = manifest["sequences"][0]["canvases"][0]
image_id = canvas0["images"][0]["resource"]["@id"]
⚠️ 上の例は IIIF Presentation API 2.x のマニフェスト構造(sequences → canvases → images → resource → @id)に基づいています。2020年公開の 3.0 では構造が変わり、manifest["items"][0]["items"][0]["items"][0]["body"]["id"] のように items をたどります(@id→id、label は {"ja":["…"]} のような言語マップに変更)。機関によって 2.x と 3.0 が混在するため、実際のマニフェストの @context や type/@type でバージョンを確認してから処理しましょう。
13.4.3 画像整理(メタデータ付きの構造化保存)とフォルダ管理法
収集した大量の画像は、適切に整理・管理しないと後の分析や引用の際に混乱してしまいます。基本は、「画像とメタデータを紐付けて保存する」ことです。画像ファイルそのものには撮影年や出典といった情報は含まれていません。したがって、ダウンロードした画像には人力またはプログラムで分かりやすいファイル名を付けるか、もしくは別途メタデータファイル(CSV や JSON、あるいは Excel シート等)に画像ファイル名と対応する属性情報を記録しておく必要があります。
フォルダ構成も工夫が必要です。資料をその出典機関やコレクションごとにフォルダ分けする方法や、研究テーマごとに分ける方法があります。最後にバックアップも重要です。せっかく収集・整理した画像データセットが消失しないよう、外部ストレージやクラウドにバックアップを取っておきましょう。
🔗 ここからが本番:集めた画像を「ディスタント・ビューイング」へ
IIIF で画像を集め、メタデータと紐づけて整理する──ここまでが「材料集め」です。実はこれは、13.2 で学んだ 注釈→編成→探索→伝達 の4段階のうち、②編成(Organize)の準備にあたります。次は集めた画像群を ①注釈(Annotate)──物体検出・色の数値化・画像埋め込みなど──にかけ、メタデータと組み合わせて ③探索(Explore)へ進みます。
マニフェスト取得
CVでラベル化
メタデータと結合・可視化
論文・公開UI
つまり IIIF(収集)と ディスタント・ビューイング(分析)は一続きです。標準化された IIIF のおかげで世界中の機関の画像を同じ方法で集められ、それを計算的に「遠くから見る」ことで、人間の目では追えない規模のパターンが見えてきます。
ソーシャルメディア(Instagram)の画像を集めて分析する
IIIF が「図書館・美術館の整った画像」を集める仕組みだとすれば、もう一つの巨大な視覚文化の現場が ソーシャルメディアです。とりわけ Instagram は画像・動画が中心の強い視覚文化を持ち、自撮り・食事・観光・ファッションといった現代の「見る/見られる」実践が日々膨大に投稿されています。13.2 で見た Selfiecity はまさにこの Instagram 画像にディスタント・ビューイングを適用した代表例でした。
13.5.1 Selfiecity はどうやって集めたか──そして今は同じ方法が使えない
Selfiecity(2013年)は、当時最大級のソーシャルデータ仲介業者 Gnip を通じて Instagram のデータにアクセスし、1週間に5都市で65万枚超を収集 → 各都市640枚・計3,200枚の自撮りを選別 → 顔解析にかけました。しかしこの手法は現在そのままでは再現できません。Gnip は消滅し、Instagram の「第三者の公開投稿を大量に取得する」公式経路も大きく制限されたためです。データ収集の前提は、数年で大きく変わります。
13.5.2 いまの公式ルートと制約(2024–2026年)
かつて個人アカウントのメディアを取得できた Instagram Basic Display API は2024年12月4日に廃止されました。現在、研究目的でデータを得る現実的な経路は次の3つに整理できます。
① Instagram Graph API
Meta の開発者基盤。ビジネス/クリエイターのアカウントが対象で、アプリ審査が必要。自分や同意した相手の投稿・インサイト、ハッシュタグ検索(週30個まで等の上限)は可能だが、第三者の任意の公開投稿を網羅的に大量取得することはできない。
② Meta Content Library(研究者向け)
Facebook・Instagram・Threads の公開コンテンツをほぼ網羅的に検索できる、Meta の研究者向けツール。資格ある学術機関の研究者が審査(ICPSR経由)を経て利用し、データは隔離環境(クリーンルーム)内で分析。旧 CrowdTangle は2024年8月に廃止され、これが事実上の後継。
③ スクレイピング(非推奨・原則禁止)
APIを使わずページから自動収集する方法。Instagram の利用規約は無許可の自動収集を禁止しており、アカウント停止やDMCA等の措置、倫理的問題のリスクを伴う。合法性は管轄やログイン状態で評価が分かれ一様でない。研究では原則として正規ルートを使うのが安全。
13.5.3 集めたあとは「ディスタント・ビューイング」へ
正規の手段で画像が集まれば、あとは 13.2 の 注釈→編成→探索→伝達 の流れに乗せられます。Selfiecity は ①注釈=顔検出・微笑スコア・頭部の傾き・性別推定、②編成=都市メタデータと結合、③探索=都市・性別ごとの分布比較、④伝達=対話的な可視化サイト、という形でこの4段階を踏みました。物体検出(写っているモノ)、色の数値化、ハッシュタグ(テキスト)との突き合わせなど、応用は多彩です。
⚠️ 研究倫理:「公開されている=自由に使ってよい」ではない
人が写った投稿は個人情報・肖像・プライバシーに関わります。公開投稿でも本人が研究利用に同意しているとは限りません。顔データの分析・再識別のリスク、未成年や機微情報への配慮、EUのGDPR等の規制、所属機関の研究倫理審査(IRB)にも注意が必要です。収集の正当性・最小限性・匿名化・公表時の配慮を、計画の段階から設計しましょう(詳しくは次節13.6)。
顔・個人情報をめぐる倫理と規制
画像を大規模に扱う研究で、いま最も注意を要するのが人の「顔」です。顔は強力な個人識別情報であり、顔認識・顔分析の普及とともに、プライバシー・監視・差別をめぐる懸念が世界的に高まっています。それに伴い法規制も急速に変化しており、数年前の「常識」が通用しません。研究者は最新の状況を踏まえて計画を立てる必要があります。
13.6.1 なぜ「顔」は特別なのか
顔から抽出した特徴量で個人を一意に識別・認証するデータは「生体情報(バイオメトリクス)」と呼ばれ、多くの法域で通常の個人情報よりも厳格に保護されます。重要なのは、単に人が写った写真と、顔認識のために技術的に処理されたデータの区別です。前者は通常の個人情報ですが、顔の特徴量を抽出して識別に使った瞬間に「生体情報」として特別な規律の対象になります(EUの GDPR では前文51・第9条がこれを定めます)。
13.6.2 変化する規制の「地図」(2024–2026年)
EU:GDPR
顔認識データは特別カテゴリの個人データ(第9条)。識別目的での処理は原則禁止で、明示的な同意や研究目的などの例外要件を満たす必要がある。
EU:AI法(AI Act)
2024年発効、禁止規定は2025年2月から適用。顔画像を無差別にスクレイピングして顔認識DBを作ることを全面禁止。職場・学校での感情認識、機微属性による生体分類も原則禁止。
米国:州法(例:イリノイ州BIPA)
生体情報の収集に書面同意を要し、個人が直接訴えられる。Meta は顔タグ機能をめぐり 6.5億ドル、テキサス州とは 14億ドルで和解(2024)。
象徴的なのが、約数十億枚の顔画像をウェブから収集した顔認識企業 Clearview AI への制裁です。イタリア・フランス・ギリシャが各2,000万ユーロ(2022)、オランダが 3,050万ユーロ(2024)の制裁金や削除命令を科しました。「公開されているウェブ上の顔画像でも、勝手に集めて使えばよい」という発想は、もはや通用しません。
13.6.3 アルゴリズムの精度格差(バイアス)
顔の分析は、誰に対しても等しく正確なわけではありません。Buolamwini と Gebru の「Gender Shades」(2018)は、商用の性別分類で肌の色が濃い女性の誤分類率が最大34.7%に達する一方、肌の色が薄い男性は0.8%という大きな格差を示しました。米 NIST の大規模検証(2019)も人口統計的な誤差の偏りを確認しています(ただし最新の高精度モデルでは格差が縮小傾向にあり、また「性別分類」と「本人識別」は別物である点に注意)。「中立な機械」ではなく、訓練データの偏りを引き継ぐ道具だと理解することが大切です。
13.6.4 歴史資料・文化遺産ならではの配慮
人文学では、過去の写真に写った人々も扱います。被写体本人やその子孫への配慮、収監者・暴力・植民地主義的なまなざしといった機微な題材の扱い、そして先住民の資料に関する CARE 原則(集団的利益・管理権限・責任・倫理)など、「公開され、技術的に分析可能だから使ってよい」では済まない問いがあります。データの最小化・匿名化(非識別化)や、所属機関の研究倫理審査(IRB)を、計画段階から組み込みましょう。
✅ 実践チェックリスト:顔・個人情報を含む画像を扱う前に
- ▢その画像の取得は正規の手段・許諾の範囲内か(規約・ライセンス・収集方法)。
- ▢顔の識別・認証を行うのか、それとも集計的な分析にとどめるのか。識別を行うなら法的根拠(同意等)はあるか。
- ▢研究目的に必要な最小限のデータか。匿名化・モザイク・集計で代替できないか。
- ▢使うモデルの精度格差・バイアスを点検し、結果の限界を明示したか。
- ▢機微な被写体・子孫・コミュニティへの配慮、IRBの確認をしたか。
- ▢アルゴリズムが何を見て・誤り・見落とすかを記録し、公表時に説明できるか。
解釈上の留意点
前節の顔・個人情報に加えて、最後に、視覚資料を研究に活用する際のより一般的な解釈上・倫理上の留意点をまとめておきます。画像は強力な情報源ですが、その利用には慎重な姿勢が求められます。
- ●文脈の重要性:視覚資料の意味は多義的で文脈に依存します。ある一枚の写真や絵画も、それが提示される文脈によって受け取られる意味が大きく変わり得ます。研究者は、画像を読む際にそのコンテクストを丁寧に復元・考慮する必要があります。例えば歴史写真を分析する際には、その写真がどこで誰によって撮影され、当時どのように発表・流通し、現在我々が見ているそのデジタル画像はどういう経路でアーカイブされたのか、といった背景に目を向けることが大切です。
- ●画像の加工・切り出し・注釈による意味の変容:研究や発表の中で、画像資料をトリミング(切り抜き)したり、一部に強調のマークを付けたり、色調を補正したりすることがあるかもしれません。こうした操作は便利ではありますが、元画像の持つ情報やバランスに影響を与えます。画像を加工して用いる場合は、その加工内容と意図を明示することが重要です。
- ●著作権と IIIF 画像利用の前提:IIIF 経由で取得できる画像の多くはパブリックドメイン(著作権保護期間満了)か、もしくは提供機関が研究教育目的での利用を許諾したものです。しかし全てが無制限に使えるとは限りません。IIIF マニフェストの license 項目や提供サイトの利用規約を必ず確認し、許諾範囲を守ることが大事です。
- ●出典表記の原則と倫理的な再利用:研究において他者の資料を用いた場合、その出典を明示するのは基本的な倫理です。画像資料も例外ではなく、引用した図版には出典(所蔵元やデータベース名、資料 ID 等)を必ず記載しましょう。パブリックドメインの画像であっても、学術出版物では「○○美術館所蔵(Public Domain)」などと明記するのが一般的です。また、人を被写体とした写真資料の場合はプライバシーや名誉への配慮も必要です。